PG 入门
PG 入门
Pavel Luzanov, Egor Rogov & Igor Levshin · 第 11 版 · PostgreSQL 17 · 2025 年
开始阅读 · 整书打印 · 英文原版 PDF · 勘误与阅读说明 · English
目录
插图
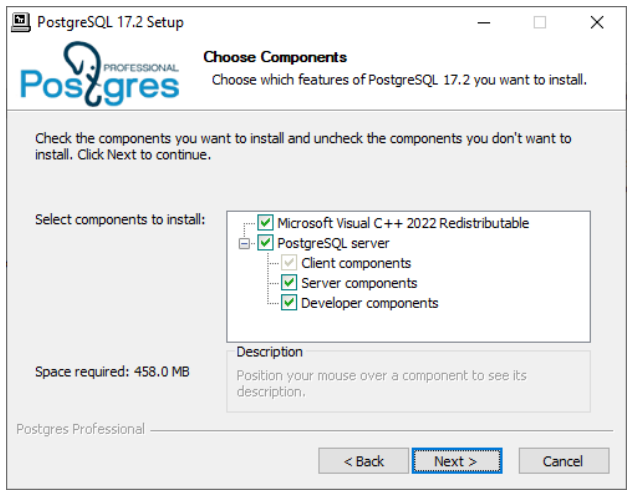
- 图 3.1 — 选择安装组件
- 图 3.2 — 选择数据目录
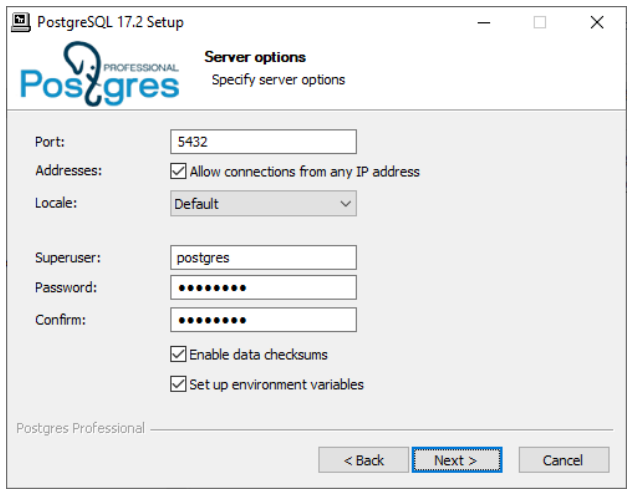
- 图 3.3 — 设置服务器连接选项
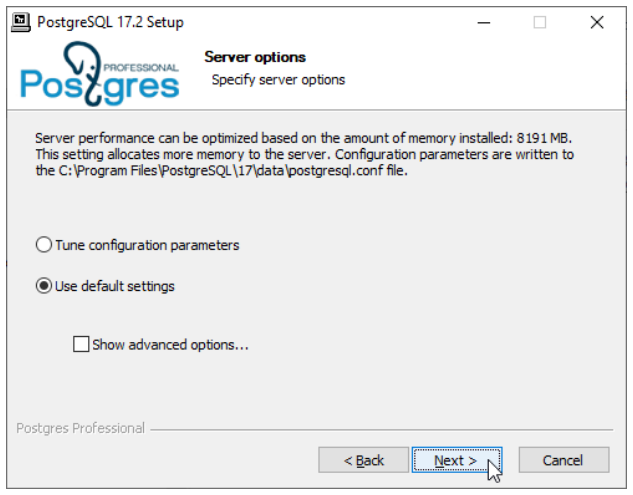
- 图 3.4 — 选择服务器的默认配置
- 图 4.1 — 从开始菜单启动 SQL Shell
- 图 5.1 — 订票数据库中的关系
- 图 5.2 — 演示数据库中的机场与航线
- 图 7.1 — 将 1C 信息库连接到 PostgreSQL
- 图 8.1 — 在 pgAdmin 中注册服务器
- 图 8.2 — 在 pgAdmin 中浏览数据库对象
- 图 8.3 — 在 pgAdmin 中运行查询
- 图 10.1 — 管理课程路径
- 图 10.2 — 开发课程路径
- 图 10.3 — Postgres Pro Enterprise 课程先修要求
- 图 10.4 — PostgreSQL:SQL 基础——书籍封面
- 图 10.5 — Evgeny Morgunov
- 图 10.6 — 数据库技术基础——书籍封面
- 图 10.7 — Boris Novikov
- 图 10.8 — PostgreSQL 14 内部原理——书籍封面
- 图 10.9 — Egor Rogov
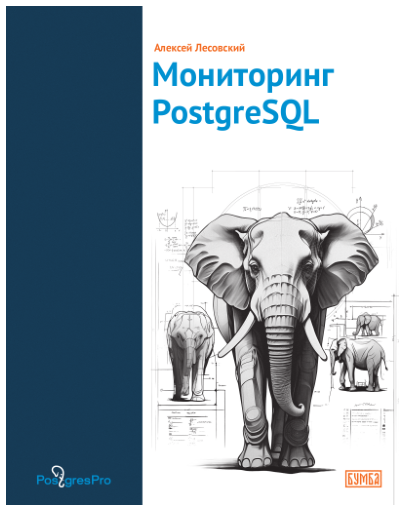
- 图 10.10 — PostgreSQL 监控——书籍封面
- 图 10.11 — Alexey Lesovsky
- 图 10.12 — 数据库指南——书籍封面
- 图 10.13 — Vladimir Komarov
关于本版
© Postgres Professional, 2016–2025。本中文译稿由 2025 年第 11 版 · PostgreSQL 17 英文 PDF 译出,沿用原版插图。原书名为 Postgres. The First Experience,英文 Web 版标题使用 Postgres: The First Experience;本站沿用中文书名《PostgreSQL 入门》。本 Web 版保留原书的章节顺序、示例和特定版本行为,原书页码引用可跳转至相应章节位置。书中的版本、课程、活动和公司信息均按原版时点保留,第 10–12 章的“我们”指原作者及 Postgres Professional。中文版本署名冯若航,使用 Codex 辅助翻译与校对。
勘误与阅读说明
以下九条说明译自英文 Web 版;该版本在对照所提供的 PDF 与 PostgreSQL 17 文档后补充了这些说明。中文正文按原版含义翻译,代码和输出保留原样。章节摘要与描述性图注也是 Web 版为方便阅读而添加的内容。下列页码均指原书印刷页码,PDF 页序比它大 1。
复制槽状态——第 18 页
在逻辑复制一节中,conflicting 和 invalidation_reason 属于 pg_replication_slots。原文误写为 pg_stat_replication。参见 PostgreSQL 17 视图定义。
直接 TLS——第 20 页
在访问控制一节中,应将 sslnegotiation=direct 与 sslmode=require、verify-ca 或 verify-full 配合使用。原文中的 requiredirect 不是有效值。参见 libpq 连接参数。
分组键——第 20 页
在查询规划与执行一节中,查询规划器为了利用已有顺序,会重新排列 GROUP BY 的键,而不是表。参见 enable_group_by_reordering。
并行函数——第 20 页
同一节还需要补充一个条件:使用子事务进行错误恢复的函数,在其所有操作都满足安全要求时,可以显式标记为 PARALLEL SAFE。函数默认仍是 PARALLEL UNSAFE;包含 EXCEPTION 块并不会自动使函数具备并行安全性。参见 CREATE FUNCTION。
同步选项——第 23 页
在其他一节中,工具的选项名为 --sync-method,原文误写为 --synch-method。参见 PostgreSQL 17 发行说明。
合并 I/O 大小——第 23 页
该节中的 io_combine_limit 在未指定单位时,以数据库块为单位,通常每块为 8 kB;它并非直接表示字节数。默认值为 128 kB。参见 io_combine_limit。
升级时的逻辑复制——第 17 页
升级说明适用于旧数据库集簇为 PostgreSQL 17 或更高版本的情况。它并不保证从 17 之前的版本升级到 17 时会保留逻辑复制槽和订阅。参见 PostgreSQL 17 发行说明。
Debian 和 Ubuntu 安装——第 30 页
软件仓库命令需要一个空格:$(lsb_release -cs)。PDF 中印成了 $(lsb_release-cs),这会尝试执行另一个命令。发行版列表和 apt-key 流程也反映了原版的情况。新安装时,请遵循 PostgreSQL 项目当前的 Debian 或 Ubuntu 安装说明,并选择 PostgreSQL 17,以与本书保持一致。
SELECT 文档链接——第 53 页
分组一节末尾的原始链接在英文 Web 版审校时返回了 HTTP 404。显示的地址保留原文写法,但链接现在指向 PostgreSQL 17 GROUP BY 参考文档。原始目标已记录在来源清单中。
引言
我们写这本小书,是为了帮助刚刚开始了解 PostgreSQL 的读者。通过本书,你将了解:
I. PostgreSQL 究竟是什么? —— 第 3 页
II. PostgreSQL 17 新特性 —— 第 15 页
III. 在 Linux 和 Windows 上安装 —— 第 25 页
IV. 连接服务器、编写 SQL 查询与使用事务 —— 第 35 页
V. 通过演示数据库学习 SQL 语言 —— 第 61 页
VI. 在应用程序中使用 PostgreSQL —— 第 89 页
VII. 服务器的基本配置 —— 第 103 页
VIII. 认识实用的 pgAdmin 应用程序 —— 第 111 页
IX. 进阶特性:
X. 教育与认证机会 —— 第 149 页
XI. 了解最新动态 —— 第 177 页
XII. 认识 Postgres Professional 公司 —— 第 181 页
希望这本书能让你与 PostgreSQL 的初次接触更加愉快,也帮助你融入 PostgreSQL 社区。祝你好运!
1 关于 PostgreSQL
PostgreSQL 是功能最丰富的自由开源数据库系统。它最初诞生于学术环境,多年来成功凝聚了庞大的开发者社区。如今,PostgreSQL 已具备大多数用户所需的全部功能,世界各地都在广泛使用它构建高负载、业务关键型系统。
历史回顾
今天的 PostgreSQL 源自 POSTGRES 项目,项目由加州大学伯克利分校教授 Michael Stonebraker 主持。在此之前,Michael Stonebraker 曾主持开发 INGRES,它是最早的关系数据库系统之一。POSTGRES 旨在重新思考之前的工作,解决 INGRES 僵化的类型系统所带来的局限。
项目始于 1985 年。到 1988 年,已有多篇学术论文发表,介绍其数据模型、POSTQUEL 查询语言(当时 SQL 尚未成为公认的标准)以及数据存储结构。
POSTGRES 有时被视为所谓的后关系数据库系统。关系模型长期以来因其局限而受到批评,但这些局限是换取严谨与简洁不可避免的代价。随着计算机技术渗透到生活的各个领域,新型应用程序不断涌现,数据库也需要支持自定义数据类型,以及继承、创建和管理复杂对象等特性。
这个数据库系统的第一个版本于 1989 年问世。此后几年,系统不断改进和增强,但在 1993 年发布 4.2 版本后,项目便终止了。然而,尽管项目已正式取消,加州大学伯克利分校校友 Andrew Yu 和 Jolly Chen 仍利用其宽松的 BSD 许可证和开放的源代码,在 1994 年重启了项目并继续开发。他们用当时已成为公认标准的 SQL 替换了 POSTQUEL 查询语言,项目也更名为 Postgres95。
到了 1996 年,Postgres95 这个名字显然难以长久使用,于是项目选用了新名字:PostgreSQL。这个名字既体现了它与原始 POSTGRES 项目的联系,也体现了对 SQL 的采用。这个名字可能不太好念,但我们仍应将它读作“Post-Gres-Q-L”,或者简称“postgres”,而不是“postgre”。
PostgreSQL 的首个发行版沿用原来的编号体系,版本号为 6.0。随着项目发展,一小群活跃用户和开发者开始接手管理工作,这个群体被称为 PostgreSQL Global Development Group(PostgreSQL 全球开发组)。
开发
关于 PostgreSQL 新版本开发与发布的所有重大决策,都由核心团队(Core team)作出。该团队目前由七人组成。
除了偶尔参与的贡献者,还有一批持续为 PostgreSQL 作出重要贡献的核心开发者,他们被称为主要贡献者(major contributors)。另有一批提交者(committers),拥有源代码仓库的写入权限。随着新开发者加入社区、其他开发者离开,这些群体的成员也在不断变化。当前的开发者名单公布在 PostgreSQL 官方网站上:postgresql.org/community/contributors。
俄罗斯开发者对 PostgreSQL 的贡献十分突出。在俄罗斯开发者如此广泛参与的全球开源项目中,它可以说是规模最大的一个。
来自克拉斯诺亚尔斯克的程序员 Vadim Mikheev 曾是核心团队成员,在 PostgreSQL 的演进与开发中发挥了重要作用。他创建了多版本并发控制(MVCC)、清理(vacuum)、预写式日志(WAL)、子查询、触发器等关键核心功能。如今,Vadim 已不再参与这个项目。
2015 年,莫斯科国立罗蒙诺索夫大学施滕贝格天文研究所的专业天文学家、研究员 Oleg Bartunov,与 Teodor Sigaev 和 Alexander Korotkov 共同创办了 Postgres Professional 公司。如今,该公司已成为俄罗斯数据库系统开发领域的主要人才培养基地。
他们的主要贡献领域包括 PostgreSQL 本地化(各国字符编码与 Unicode 支持)、全文检索、数组和半结构化数据(hstore、json、jsonb)的处理,以及新的索引方法(GiST、SP-GiST、GIN 和 RUM、Bloom)。他们还开发了许多广受欢迎的扩展。
PostgreSQL 的发布周期通常约为一年。在此期间,社区会收到来自全球贡献者的补丁,包括错误修复、更新和新特性。按照惯例,所有补丁都会在 pgsql-hackers 邮件列表中讨论。如果社区认为某个想法有用、实现正确,而且代码通过了规定的、由其他开发者进行的代码审查,这个补丁就会被纳入下一个发行版。
在某个时间点(通常是春季,距发布约半年),项目会宣布进入代码稳定阶段:所有新特性推迟到下一版本,只接受错误修复以及对已纳入补丁的改进。在发布周期内,还会推出测试版(beta)。临近周期结束时,会构建一个候选发布版(release candidate),随后不久便会发布 PostgreSQL 的新主版本。
过去,主版本号由两个数字组成。2017 年,项目决定改用单个数字,因此 9.6 之后的版本是 PostgreSQL 10。目前最新的版本是 2024 年 9 月发布的 PostgreSQL 17。
在准备新版本的过程中,开发者可能会发现并修复其中的错误。最关键的修复会被移植到先前的版本中。社区通常每季度发布一次更新,这些次版本汇集了相应的修复。例如,12.5 版本包含对 12.4 版本的错误修复,而 17.1 版本则提供对 PostgreSQL 17.0 的修复。
支持
PostgreSQL 全球开发组为每个主版本提供五年的支持。支持与开发工作都通过邮件列表组织。一份按要求提交的错误报告很可能很快得到处理;错误修复最快可在 24 小时内发布。
除社区支持外,不同国家的多家公司也提供 7×24 小时的 PostgreSQL 商业支持,其中包括 Postgres Professional(www.postgrespro.com)。
现状
PostgreSQL 是最受欢迎的数据库之一。依托学术研究奠定的坚实基础,经过数十年的发展,它已成长为企业级产品,如今已成为商业数据库切实可行的替代选择。不妨看看目前最新发行版 PostgreSQL 17 的主要特性,你就能亲自感受到这一点。
可靠性与稳定性
对于处理业务关键数据的企业级应用程序,可靠性尤为重要。为此,PostgreSQL 支持热备服务器、时间点恢复,以及多种复制方式(同步、异步和级联复制)。
安全性
PostgreSQL 支持安全的 SSL 连接,并提供多种身份验证方式,包括密码验证(含 SCRAM)、客户端证书,以及外部身份验证服务(LDAP、RADIUS、PAM、Kerberos)。
在用户管理和数据库访问控制方面,PostgreSQL 提供以下功能:
创建和管理新用户及组角色
基于角色和组控制对数据库对象的访问
行级与列级安全性
通过内置的 SE-PostgreSQL 功能支持 SELinux(强制访问控制)
Postgres Professional 发布的一个定制 PostgreSQL 版本已获得俄罗斯联邦技术与出口管制局认证,可用于处理个人数据和涉密信息的数据处理系统。
SQL 标准符合性
随着 ANSI SQL 标准不断演进,PostgreSQL 也在持续增加对它的支持。从 SQL-92 到最新的 SQL:2023,各个版本的标准都是如此。例如,PostgreSQL 17 完整支持 SQL:2016 标准中描述的所有 JSON 操作。
总体而言,PostgreSQL 对 SQL 标准的符合程度很高,支持 177 项必选特性中的 170 项,以及许多可选特性。
事务支持
PostgreSQL 完整支持 ACID 特性,并基于多版本并发控制(MVCC)实现高效的事务隔离。除不同进程并发更新同一行的情况外,这种方法在所有其他情况下都能避免加锁。读事务从不阻塞写事务,写事务也从不阻塞读事务。
即使在最严格的可串行化隔离级别下,情况也是如此。该级别采用创新的可串行化快照隔离(Serializable Snapshot Isolation)机制,确保不会出现串行化异常,并保证并发执行事务的结果与顺序执行相同。
面向应用程序开发者
应用程序开发者可以借助丰富的工具集创建各类应用程序:
支持多种服务器端编程语言:内置的 PL/pgSQL(与 SQL 紧密集成)、适合性能关键任务的 C,以及 Perl、Python、Tcl、JavaScript、Java 等。
提供数据库访问 API,让几乎任何语言编写的应用程序都能访问数据库,其中包括标准的 ODBC 和 JDBC API。
提供丰富的数据库对象,可以在服务器端高效实现任意复杂程度的逻辑:表和索引、序列、完整性约束、视图和物化视图、分区、子查询和 WITH 查询(包括递归查询)、聚合函数和窗口函数、存储函数、触发器等。
灵活的全文检索系统,支持多种语言,并配有高效的索引访问方法。
支持 NoSQL 中常见的半结构化数据:hstore(存储键值对)、xml、json(以文本形式或更强健的 jsonb 二进制格式表示)。
外部数据包装器(Foreign Data Wrappers)。这项功能允许按照 SQL/MED 标准,以外部表的形式添加新的数据源。任何主流数据库都可以作为外部数据源。PostgreSQL 提供对外部数据的完整支持,包括写入访问和分布式查询执行。
可伸缩性与性能
PostgreSQL 能够利用现代多核 CPU 架构。随着核心数量增加,其性能几乎呈线性增长。
PostgreSQL 可以并行执行查询和某些命令(例如创建索引和清理)。在这种模式下,读取和连接由多个并发进程执行。查询的即时编译(JIT)可以更充分地利用硬件资源,从而加快操作。每个 PostgreSQL 版本都会增加新的并行处理特性。
水平伸缩既可以依靠物理复制,也可以依靠逻辑复制。借助这些机制,可以构建基于 PostgreSQL 的集群,实现高性能、容错和跨地域分布。这类系统的例子包括 Citus(Citusdata)、Postgres-BDR(2ndQuadrant)、Multimaster 和 BiHA(Postgres Professional),以及 Patroni(Zalando)。
查询规划器
PostgreSQL 使用基于代价的查询规划器。规划器利用收集到的统计信息,在数学模型中同时考虑磁盘操作和 CPU 时间,即使是最复杂的查询也能进行优化。先进商业数据库系统所具备的各种访问路径和连接方法,它都可以使用。
索引
PostgreSQL 提供多种类型的索引。除了传统的 B-树(B-tree),还可以使用许多其他访问方法。
Hash:基于哈希的索引。与 B-树不同,这类索引只能用于等值检查,但在某些情况下可能更加高效、紧凑。
GiST:一种通用的平衡搜索树。这种访问方法用于无法排序的数据。例如,R-树可以为平面上的点建立索引,支持快速的 k 近邻(k-NN)搜索,也可以为相互重叠的区间建立索引。
SP-GiST:一种通用的非平衡树,将搜索空间划分为互不相交的嵌套分区。例如,用于空间数据的四叉树,以及用于文本字符串的基数树。
GIN:一种通用倒排索引,用于包含多个元素的复合值。它主要用于全文检索,查找包含搜索查询中所用词语的文档。另一个例子是在数据数组中搜索元素。
RUM:对 GIN 方法的增强,用于全文检索。这种索引以扩展形式提供,可以加速短语搜索,并按相关性顺序返回结果,无需额外计算。
BRIN:一种紧凑的数据结构,在索引大小和搜索效率之间作出取舍。这种索引适用于规模庞大的聚簇表。
Bloom:基于布隆过滤器的索引。它采用紧凑的表示方式,可以快速过滤掉不匹配的元组,但对剩余元组还需要再次检查。
许多索引类型既可以建立在单列上,也可以建立在多列上。无论哪种类型,索引不仅可以建立在列上,还可以建立在任意表达式上。也可以针对特定的行集合创建部分索引。覆盖索引能够加速查询,因为所需的全部数据都可以直接从索引中获取,无需访问堆。
规划器可以使用位图扫描,将多个索引组合起来,加快数据访问。
跨平台支持
PostgreSQL 既可以运行在 Unix 操作系统上(包括服务器和客户端 Linux 发行版、FreeBSD、Solaris 和 macOS),也可以运行在 Windows 系统上。
其可移植的开源 C 代码使 PostgreSQL 能够在多种平台上构建,即使社区没有为这些平台提供软件包也不例外。
可扩展性
PostgreSQL 架构的一大优势是可扩展性。无需修改系统核心代码,用户就可以添加各种功能,例如:
数据类型
支持新数据类型的函数和操作符
索引访问方法和表访问方法
服务器端编程语言
外部数据包装器
可加载的扩展
完善的扩展支持使开发者能够实现任意复杂程度的新功能,按需安装,而无需修改 PostgreSQL 核心。例如,下列复杂系统都以扩展形式实现:
CitusDB:实现大规模并行查询执行,以及不同 PostgreSQL 实例之间的数据分布(分片)。
PostGIS:最流行、最强大的地理信息数据处理系统之一。
- TimescaleDB:提供时间序列数据支持,包括专门的分区和分片功能。
仅 PostgreSQL 17 的标准发行版就包含约五十个经实践证明实用而可靠的扩展。
易于获取和使用
宽松的 PostgreSQL 许可证与 BSD、MIT 许可证类似,允许不受限制地使用 PostgreSQL;你也可以不受限制地修改 PostgreSQL 代码,并将其集成到其他产品中,包括商业软件和闭源软件。
独立性
PostgreSQL 不属于任何一家公司,而是由汇聚了世界各地开发者的国际社区共同开发。这意味着,使用 PostgreSQL 的系统不依赖某个特定供应商,因此能够在任何情况下保护已有投资。
2 PostgreSQL 17 新特性
Web 版说明。本章包含几处源文错误和需要补充的版本限定。阅读下方正文时,请同时参阅 PostgreSQL 17 勘误。
如果你熟悉 PostgreSQL 的早期版本,本章可以帮助你了解过去一年里发生了哪些变化。这里仅介绍部分更新;完整变更列表请参阅发行说明:postgrespro.com/docs/postgresql/17/release-17. 你也可以关注我们的博客,了解最新动态:https://habr.com/en/companies/postgrespro/articles/.
SQL 命令
改进了 MERGE 命令。 新增的 WHEN NOT MATCHED BY SOURCE 子句可以处理目标关系中存在、源关系中不存在的行。现在还支持 RETURNING 子句,也可以像使用表一样将视图用作目标。
借助新增的 on_error 参数,现在可以让 COPY FROM 命令忽略某些列中值的格式无效所引发的错误。log_verbosity 参数则会以 NOTICE 级别的消息显示被跳过的值。未来的改进可能会允许将无效值放入单独的表中。
现在可以修改表中的生成表达式,方法是在 ALTER COLUMN 命令中使用 SET EXPRESSION 子句。此前,只能删除该表达式。
现在可以按照 SQL 标准,使用表示当前时区的简写 AT LOCAL,替代带有时区值的 AT TIME ZONE。
函数与类型
重载后的 random 函数现在接受两个参数,分别指定随机数的最小值和最大值。支持 int、bigint 和 numeric 值。
interval 类型现在支持无穷值。
除了用于十六进制的 to_hex,还增加了类似的函数,分别用于二进制(to_bin)和八进制(to_oct)。
为 to_timestamp 函数新增了格式模板: TZ(时区)和 OF(相对于 UTC 的偏移)。此前,必须使用 to_char。
SQL 标准定义的 xmltext 函数将输入字符串转换为 XML,并正确转义特殊字符。
新增 Unicode 函数: unicode_assigned 检查字符串中的每个字符是否都有有效的 Unicode 值,unicode_version 返回 PostgreSQL 的 Unicode 版本,而 icu_unicode_version 返回 ICU 版本。
现在,一些带有多个参数的聚合函数已在定义中为参数指定了名称。
SQL/JSON
实现 SQL/JSON 2016 标准的这部壮丽史诗,如今终于落幕。 此前缺少的 JSON_EXISTS、JSON_QUERY、JSON_VALUE 和 JSON_TABLE 函数终于全部到位。jsonpath 语言也增加了新的数据转换方法,可以将数据转换为 bigint、boolean、date、decimal、integer、number、string、time_tz、time、timestamp_tz 和 timestamp。
逻辑复制
升级现在容易多了。 pg_upgrade 工具会将复制槽迁移到发布端,订阅端只需更新连接字符串。升级订阅端时,所有订阅都会完整保留,复制可以继续,无需重新同步。
逻辑副本可以基于物理副本创建:物理副本的所有表都已同步,因此配置复制不会花费太多时间。新工具 pg_createsubscriber 会将物理副本切换到读写模式,在两台服务器的一个或多个数据库中创建成对的发布端和订阅端,并在订阅属性中指定继续复制的起始位置。
逻辑复制槽会迁移到副本上,并持续更新。完成计划内切换后,只需更新连接字符串,使其指向新的服务器,复制即可恢复。
通过 pg_stat_subscription 视图新增的 worker_type 列,可以查看复制工作进程正在做什么。
可能的值有:apply、parallel apply 和 table synchronization。
pg_stat_replication 视图中的 conflicting 和 invalidation_reason 列,会显示逻辑复制槽是否失效,以及失效的原因。
此外,针对存在大量子事务的情况,逻辑解码以及依赖它的逻辑复制都得到了显著优化。
清理
借助基于基数树的新死元组存储方式,清理现在需要的内存大幅减少。此外,元组 ID 查找速度更快,内存改为动态分配(此前会一次性分配全部 maintenance_work_mem),1 GB 的硬性上限也已取消。现在,大多数表只需一轮就能完成清理,避免反复扫描索引。
清理监控得到改进。 pg_stat_progress_vacuum 新增了两列:待清理的索引总数(indexes_total),以及已清理的索引数量(indexes_processed)。
如果在清理过程中冻结行,产生的 WAL 现在更少了。这两个操作会合并为一条 WAL 记录。
备份与升级
PostgreSQL 新增了页级增量备份。walsummarizer 进程(配合 summarize_wal 参数)读取 WAL,记录哪些页被修改。pg_basebackup 工具新增的 --incremental 参数可启用增量备份,并利用复制协议的新特性。恢复工具 pg_combinebackup 会将增量备份及其依赖的所有备份合并为完整备份。
在 pg_basebackup 和 pg_receivewal 中,可以通过 dbname 参数指定要连接的数据库。前者使用 -R 选项时,还会在写入 postgresql.auto.conf 时将数据库名添加到 primary_conninfo 中。这两个工具本身都不需要数据库名,但通过代理连接,以及在副本上配置复制槽同步时,都需要提供它。
为 pg_dump 新增了选项: --filter 指定一个文件,其中列出要纳入转储或从转储中排除的对象。--exclude-extension 则排除一组扩展。
对于含有多个大对象和表的数据库,使用 pg_upgrade 升级更快了。pg_dump 现在会在备份索引中对大对象进行分组,而 pg_restore 则按 --transaction-size 指定的事务大小提交更改。此外,并行恢复中主导进程的逻辑也得到了改进。
访问控制
新增权限 MAINTAIN,用于 ANALYZE、VACUUM(包括 VACUUM FULL)、CLUSTER、REINDEX、REFRESH MATERIALIZED VIEW 和 LOCK TABLE。加入 pg_maintain 角色后,即可对数据库中的每个关系拥有这项权限。
使用 libpq 的客户端应用程序现在可以通过 TLS 直接连接。将 sslnegotiation 参数设置为 requiredirect 即可启用。
新的默认权限显示方式: 如果没有权限,psql 会返回 (none),同时也会遵循 \pset null 的设置。
查询规划与执行
规划器现在可以使用物化 CTE 的统计信息,包括 CTE 的列统计信息和行排序顺序。
规划器可以交换 GROUP BY 中的表,例如借此利用索引或增量排序。
包含子事务的函数现在是 PARALLEL SAFE 的。 这尤其包括带有 EXCEPTION 块的 PL/pgSQL 函数。此外,计划的并行部分现在也可以包含 InitPlan 节点。
EXPLAIN 命令的改进:
memory参数显示生成计划时使用了多少内存。serialize参数显示将查询结果转换为文本或二进制格式、以便发送给客户端的代价(尤其是 TOAST 数据的重组)。SubPlan 和 InitPlan 节点的可读性得到改进。
许多索引特性过去一直仅适用于 B-树。现在,其他类型的索引也可以使用这些特性:
- 哈希索引可用于识别逻辑复制订阅端被修改的行。
增量排序可以配合 GiST 和 SP-GiST 索引使用。
BRIN 索引可以并行创建。
分区方面的一些改进:
现在可以设置排他约束。
完整支持
GENERATED AS IDENTITY列。
监控
新视图 pg_stat_checkpointer 显示检查点进程的统计信息,这些信息此前由 pg_stat_bgwriter 提供。它还会显示副本重启点的统计信息。pg_stat_bgwriter 中的 buffers_backend 和 buffers_backend_fsync 列已移除,因为 pg_stat_io 现在能够提供更准确的进程数据。
pg_stat_statements 视图:
新增列,用于跟踪全部统计信息的重置时间和最短、最长耗时统计信息的重置时间(
stats_since和minmax_stats_since)。归一化命令
CALL、PREPARE TRANSACTION、COMMIT/ROLLBACK PREPARED和DEALLOCATE:将它们的参数替换为常量值,从而将这些命令作为单个事件记录。
现在可以在 pg_stats 中查看范围类型列的统计信息。
扩展开发者现在可以定义自己的等待事件。dblink 和 postgres_fdw 扩展的开发者率先使用了这项功能。
除了文档之外,现在也可以在新视图 pg_wait_events 中查看等待事件的类型和描述。
事件触发器
终于可以为数据库连接事件创建 ON LOGIN 触发器了。
事件触发器支持 REINDEX 命令。
event_triggers 参数用于启用或禁用事件触发器,主要用于调试。
配置参数
由于实现与效率方面出现了问题,最初在 PostgreSQL 9.6 中引入的参数 old_snapshot_threshold 已被移除。
新参数 transaction_timeout 限制事务的总时长。 过去的 statement_timeout 和 idle_in_transaction_session_timeout 参数无法保证事务在指定时间内完成或终止。
当 huge_pages = try 时,huge_pages_status 参数会显示是否分配了大页。
一些新增配置参数用于设置 SLRU 缓存大小,以便进行更细致的调优:
commit_timestamp_buffers—— 提交时间;multixact_member_buffers和multixact_offset_buffers—— 多事务(multitransaction,MultiXact);subtransaction_buffers—— 嵌套事务;notify_buffers—— 异步消息;
transaction_buffers—— 事务状态;serializable_buffers—— 可串行化事务冲突。
ALTER SYSTEM 命令现在可以将自定义参数写入 postgresql.auto.conf。allow_alter_system 参数可以阻止 ALTER SYSTEM 意外修改配置。
本地化
新增内置提供者,支持 C 和 C.UTF8 区域设置。
其他
对于某些工具,可以用 --synch-method 选项设置磁盘同步方法,包括 initdb、pg_basebackup、pg_checksums、pg_rewind、pg_upgrade 和 pg_dump。默认方法是 fsync。
walsender 进程会尽可能直接从缓冲区读取 WAL 记录,绕过文件系统。
此前,PostgreSQL 为每个页单独发起一次系统调用,并寄望于操作系统将这些操作合并。现在,有了多块读取基础设施:可以一次读取一系列页(每次最多 io_combine_limit 字节)。未来还将加入异步读取,在页到达时就开始处理,而无需等待整个操作完成。
3 安装与快速入门
Web 版说明。执行 Debian 或 Ubuntu 软件仓库相关命令前,请先阅读安装勘误:原文中的
lsb_release -cs少了一个空格,而且软件仓库的配置方式自本书出版后已有变化。
要开始使用 PostgreSQL,需要做哪些准备?本章将介绍如何安装 PostgreSQL,以及如何管理相应的服务。下一章,我们将创建一个简单的数据库,尝试一些基本的 SQL 查询。
我们将使用 PostgreSQL 17 的常规发行版(通常称为“vanilla”,即原版)。安装和配置 PostgreSQL 的过程因操作系统而异:
如果你使用 Windows,请继续往下读。
如果要在基于 Linux 的 Debian 或 Ubuntu 系统上配置 PostgreSQL,请跳到第 30 页。
其他操作系统的安装说明可以在线查看:www.postgresql.org/download.
你也可以使用 Postgres Pro Standard 17:它与原版 PostgreSQL 完全兼容,包含一些由 Postgres Professional 开发的附加特性,试用或用于教学时免费。如果选择它,请参阅 postgrespro.com/products/download 上的安装说明。
Windows
安装
下载 PostgreSQL 安装程序,运行后选择安装语言:postgrespro.com/windows.
安装程序采用常见的向导界面:如果默认选项符合需要,只需一路点击“下一步”(Next)按钮。下面我们来看看主要步骤。
选择组件(如果不确定如何选择,保留当前选项即可):
接下来需要指定 PostgreSQL 的安装目录。默认情况下,PostgreSQL 服务器安装在 C:\Program Files\PostgreSQL\17。
你还可以指定数据目录的位置。
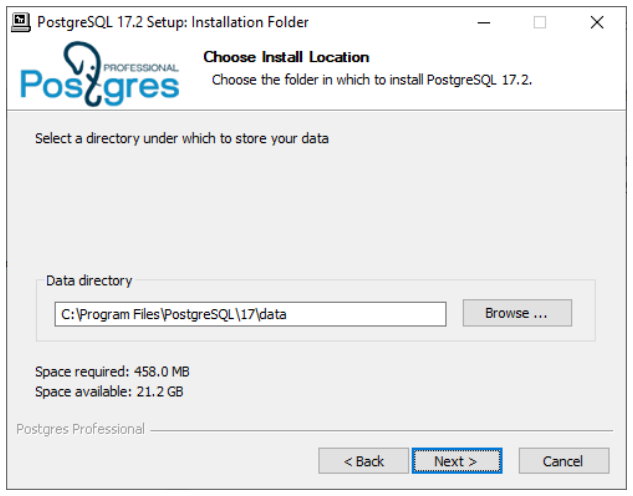
数据库系统中存储的所有信息都会放在这个目录中。因此,如果打算存放大量数据,请确保有足够的磁盘空间。
如果打算存储非英语数据,请务必选择相应的区域设置;如果 Windows 的区域设置已经正确,也可以保留“默认”(Default)。
输入并确认数据库用户 postgres 的密码。还应选中“设置环境变量”(Set up environment variables)复选框,以便以当前操作系统用户的身份连接 PostgreSQL 服务器。
其他字段都可以保留默认设置。
如果安装 PostgreSQL 只是为了学习,可以选择“使用默认设置”(Use the default settings),让数据库系统占用更少的内存。
服务管理与主要文件
安装 PostgreSQL 时,系统会注册“postgresql-17”服务。这个服务会在系统启动时,以 Network Service 账户的身份自动运行。如有需要,可以通过 Windows 的标准选项修改服务设置。
要临时停止服务,请在安装时选择的开始菜单子文件夹中运行“停止服务器”(Stop Server)程序。
要启动服务,请在同一文件夹中运行“启动服务器”(Start Server)程序。
如果启动服务时发生错误,可以查看服务器日志来了解原因。日志文件位于安装时选择的数据库目录下的 log 子目录中(通常是 C:\Program Files\PostgreSQL\17\data\log)。日志会定期切换到新文件。你可以根据最后修改日期查找所需的文件,也可以根据文件名查找;文件名包含切换到该文件时的日期和时间。
服务器设置由几个重要的配置文件决定,它们位于数据库目录中。刚开始使用 PostgreSQL 时,无需修改这些文件,但在实际工作中一定会用到。不妨打开看看,文件内都有详尽的说明:
postgresql.conf 是主配置文件,包含服务器参数。
pg_hba.conf 定义访问规则。出于安全考虑,默认配置只允许从本机访问,并要求进行密码验证。
现在,我们已经可以连接数据库,尝试一些命令和 SQL 查询了。请转到第 35 页的“体验 SQL”一章。
Debian 和 Ubuntu
安装
如果你使用 Linux,需要添加 PGDG(PostgreSQL 全球开发组)软件包仓库。目前支持的 Debian 版本为 10“Buster”、11“Bullseye”和 12“Bookworm”;支持的 Ubuntu 版本为 20.04“Focal”、22.04“Jammy”、23.10“Mantic”和 24.04“Noble”。
在控制台窗口中运行以下命令:
添加仓库后,我们来更新软件包列表:
开始安装前,先检查本地化设置:
如果打算处理非英语数据,可能需要配置 LC_CTYPE 和 LC_COLLATE 变量。例如,对于法语,将这两个变量设置为“fr_FR.UTF8”比较合适,尽管“en_US.UTF8”也可能适用:
还应确认操作系统已安装所需的区域设置:
如果没有安装,请按以下方式生成:
现在可以开始安装了:
这是最后一步;安装命令完成后,PostgreSQL 就已安装并启动。要检查服务器是否可用,请运行:
如果一切顺利,就会返回当前的 PostgreSQL 版本。
服务管理与主要文件
安装 PostgreSQL 时,系统会创建一个专用用户 postgres。所有服务器进程都以该用户的身份运行,所有数据库文件也都属于该用户。PostgreSQL 会在操作系统启动时自动启动。在默认设置下,这不会带来什么问题:如果你没有使用数据库服务器,它只会消耗很少的系统资源。如果决定禁用自动启动,请运行:
要临时停止数据库服务,请输入:
可以按以下方式启动服务:
也可以检查服务的当前状态:
如果服务启动失败,请查看服务器日志了解详情。仔细查看 /var/log/postgresql/postgresql-17-main.log 中最新的日志记录。
数据库中存储的所有信息都位于 /var/lib/postgresql/17/main/ 目录下。如果打算存放大量数据,请确保有足够的磁盘空间。
服务器设置由几个配置文件决定。刚开始使用时,无需编辑所有这些文件,但不妨先看看,因为以后一定会用到:
/etc/postgresql/17/main/postgresql.conf 是主配置文件,包含服务器参数。
/etc/postgresql/17/main/pg_hba.conf 文件定义访问设置。出于安全考虑,默认配置只允许从本机访问,并且必须使用与当前操作系统用户同名的数据库用户身份。
现在,该连接数据库,尝试 SQL 了。
4 体验 SQL
通过 psql 连接
要连接数据库服务器并开始执行命令,需要一个客户端应用程序。在“应用中的 PostgreSQL”一章中,我们将讨论如何从使用不同编程语言编写的应用程序中发送查询。这里我们将介绍如何在命令行的交互模式下使用 psql 客户端。
如今,许多人并不喜欢命令行。不过,掌握它确实很有价值。
首先,psql 是所有 PostgreSQL 软件包都包含的标准客户端应用程序,因此总是可以使用。拥有定制的环境当然有好处,但到了陌生系统上,也不必因此无所适从。
其次,psql 很适合执行日常 DBA 任务、编写小型查询以及自动化流程。例如,可以使用它定期在数据库服务器上部署应用程序代码更新。psql 客户端还提供了自己的命令,帮助你了解数据库对象,并以方便的格式显示表中存储的数据。
不过,如果你习惯使用图形用户界面,可以尝试 pgAdmin(稍后还会再次介绍)或其他类似产品:wiki.postgresql.org/wiki/Community_Guide_to_PostgreSQL_GUI_Tools.
要在 Linux 系统上启动 psql,请运行以下命令:
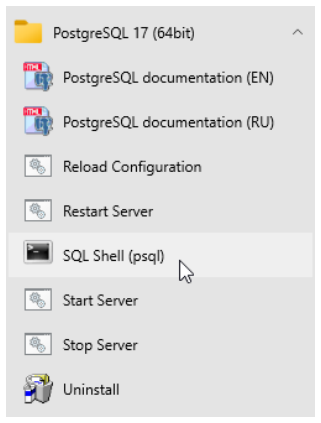
在 Windows 上,打开“开始”菜单并启动“SQL Shell (psql)”程序。出现提示后,输入安装 PostgreSQL 时为 postgres 用户设置的密码。
Windows 用户在终端查看非拉丁字母字符时可能遇到编码问题。如果出现这种情况,请确保在终端窗口的属性中选择了 TrueType 字体(通常是“Lucida Console”或“Consolas”)。
这样,在两种操作系统上都应该看到相同的提示符:postgres=#。这里的“postgres”是当前连接的数据库名称。单个 PostgreSQL 服务器可以提供多个数据库,但你一次只能使用其中一个。
现在来尝试几个命令。只输入粗体显示的部分;提示符和系统响应仅为方便起见列出。
数据库
创建一个名为 test 的新数据库:
别忘了用分号结束每条命令:PostgreSQL 会一直等待你继续输入,直到输入这个符号(因此可以把命令拆成多行)。
现在连接到刚创建的数据库:
如你所见,命令提示符已变为 test=#。
刚才输入的命令看起来不像 SQL,因为它以反斜杠开头。这是只能在 psql 中运行的特殊命令约定。如果使用 pgAdmin 或其他 GUI 工具,请跳过所有以反斜杠开头的命令,或者寻找等效命令。
psql 命令有不少,我们稍后会用到其中一些。现在可以运行以下命令,查看 psql 命令的完整列表:
参考信息较多,通常会由操作系统的分页器程序显示,一般是 more 或 less。
表
关系数据库管理系统以表的形式呈现数据。表的结构由列定义,数据本身存储在表的行中。数据没有顺序,因此各行不一定按照加入表中的顺序存储。
每一列都有一个数据类型。各行中与这一列对应的字段值都必须属于该类型。你可以使用 PostgreSQL 提供的多种内置数据类型(postgrespro.com/doc/datatype),也可以添加自定义类型,但这里我们只介绍几种主要类型:
integertextboolean,这是一种取true或false值的逻辑数据类型
除了数据类型定义的常规值外,字段还可以是 NULL。它可以解释为“值未知”或“值未设置”。
创建一个大学课程表:
注意,psql 命令提示符发生了变化:这表示命令会在新行继续输入。为方便起见,下面的示例中不再重复每一行的提示符。
上述命令创建了包含三列的 courses 表:c_no 指定以文本字符串表示的课程编号,title 提供课程名称,hours 以整数表示授课课时数。
除了列和数据类型,还可以定义会自动检查的完整性约束:PostgreSQL 不会允许无效数据进入数据库。本例添加了 PRIMARY KEY 约束,并将其应用于 c_no 列。这意味着该列中的所有值都必须唯一,并且不允许使用 NULL。这样的列可用于区分表中的不同行。所有可用的约束见 postgrespro.com/doc/ddl-constraints。
你可以在文档中查找 CREATE TABLE 命令的完整语法,也可以直接在 psql 中查看命令行帮助:
每个 SQL 命令都有这样的参考信息。要获取 SQL 命令的完整列表,请不带参数运行 \help。
填充表中的数据
将一些行插入刚创建的表:
如果需要从外部来源批量加载数据,INSERT 命令不是最佳选择。相反,可以使用专门为此设计的 COPY 命令:postgrespro.com/doc/sql-copy.
后续示例还需要另外两个表:students 和 exams。
对于每名学生,我们将存储其姓名和入学年份(起始年份)。学生 ID 编号将作为学生的标识符。
exams 表包含学生在相应课程中取得的所有成绩。因此,学生和课程通过多对多关系连接:每名学生可以参加多门课程的考试,每场考试也可以由多名学生参加。
表中的每一行都由学生 ID 和课程编号的组合唯一标识。适用于多个列的这种完整性约束由 CONSTRAINT 子句定义:
此外,这里的 REFERENCES 子句定义了两个引用完整性检查,称为外键。这样的键表示一个表中的值引用另一个表中的行。
每次对数据库执行操作后,PostgreSQL 都会检查 exams 表中的所有 s_id 标识符是否对应真实学生(即 students 表中的条目),同时检查 c_no 课程编号是否对应真实课程。因此,无论用户执行什么操作或应用程序出现什么错误,都不可能给不存在的课程或不存在的学生赋分。
为学生录入几项成绩:
数据检索
简单查询
要从表中读取数据,请使用 SQL 语句 SELECT。例如,我们来显示 courses 表中的两列。必要时,AS 子句可以重命名列:
星号 * 会显示所有列:
在生产应用程序中,建议只显式指定真正需要的列:这样查询执行得更高效,结果也不会受以后新增列的影响。但在交互式查询中,直接使用星号即可。
结果可能包含多行相同的数据。即使原表中的所有行都不相同,如果没有显示所有列,数据也可能看起来重复:
要选择所有不同的入学年份,请在 SELECT 后指定 DISTINCT 关键字:
详情见文档:postgrespro.com/doc/sql-select#SQL-DISTINCT.
一般来说,可以在 SELECT 语句后使用任意表达式。如果省略 FROM 子句,查询将返回一行。例如:
从表中选择数据时,通常需要只返回满足某个条件的行。这个过滤条件在 WHERE 子句中指定:
条件必须是逻辑类型。例如,它可以包含操作符 =、<>(或 !=)、>、>=、<、<=,也可以像普通编程语言一样使用逻辑运算 AND、OR、NOT 和括号组合简单条件。
处理 NULL 稍微复杂一些。结果只包含过滤条件为真的行;如果条件为假或未定义,该行就会被排除。
请记住:
将某个值与
NULL比较的结果是未定义的。对
NULL执行逻辑运算的结果通常是未定义的(例外:true OR NULL = true、false AND NULL = false)。要检查值是否未定义,可使用以下操作符:
IS NULL(IS NOT NULL)和IS DISTINCT FROM(IS NOT DISTINCT FROM)。
coalesce 表达式常用于将 NULL 值替换为其他内容,例如文本类型替换为空字符串,数值类型替换为零。
更多详情见文档:postgrespro.com/doc/functions-comparison.
连接
设计良好的数据库不应包含冗余数据。例如,exams 表不应包含学生姓名,因为可以通过学生证号在另一张表中找到这些信息。
因此,为了在查询中获取所有所需的值,通常需要连接多个表,并在 FROM 子句中指定它们的名称:
此结果称为表的直积或笛卡尔积:一个表的每一行都会与另一个表的每一行拼接。
通常,如果在 WHERE 子句中指定连接条件,就能得到更有用、信息更丰富的结果。让我们将课程与相应的考试匹配起来,获取所有课程的全部成绩:
连接表的另一种方式是显式使用 JOIN 关键字。让我们显示所有学生及其“Networks”课程成绩:
从数据库角度看,这些查询完全等价,因此可以使用你觉得更自然的任何方法。
在本例中,如果连接子句左侧指定的表中的行在右侧表中没有匹配项,结果不会包含这些行:尽管条件应用于课程,但没有参加这门课程考试的学生也会被排除。要将所有学生都包含在结果中,我们必须使用外连接:
注意,左表中没有右表对应项的行会被添加到结果中(因此该操作称为 LEFT JOIN)。此时右表的相应值为 NULL。
WHERE 条件会应用于连接操作的结果。因此,如果将课程限制从连接条件移到 WHERE 子句中,Nina 就会因相应的 exams.c_no 为 NULL 而从结果中排除:
不要害怕连接。对于数据库管理系统来说,这是常见操作,而 PostgreSQL 提供了整套高效机制来执行连接。不要在应用程序层连接数据;让数据库服务器妥善处理。
更多详情见文档:postgrespro.com/doc/sql-select#SQL-FROM.
子查询
SELECT 操作返回一张表,它既可以像我们已经看到的那样作为查询结果显示,也可以用于另一个 SQL 查询。用括号括起来的这种嵌套 SELECT 命令称为子查询。
如果子查询恰好返回一行一列,就可以把它作为普通的标量表达式使用:
如果用于 SELECT 表达式列表中的标量子查询不包含任何行,则返回 NULL(如上例结果的最后一行)。因此,可以用连接替换标量子查询来展开它们,但必须使用外连接。
标量子查询也可用于过滤条件。让我们显示 2014 年后入学的学生参加的所有考试:
还可以为返回任意数量行的子查询添加过滤条件。SQL 为此提供了几个谓词。例如,IN 会检查子查询返回的表是否包含指定值。
让我们显示在指定课程中取得过任何成绩的所有学生:
NOT IN 形式的谓词也会返回相反结果。例如,以下查询会返回没有取得过任何优秀成绩的学生列表:
注意,查询结果也可能包含完全没有取得任何成绩的学生。
另一个选项是使用 EXISTS 谓词,它会检查子查询是否至少返回一行。使用该谓词,可以将前一个查询改写如下:
更多详情见文档:postgrespro.com/doc/functions-subquery.
在上面的示例中,我们为列名加上表名以避免歧义,但这并不总是足够。例如,同一张表可能在查询中使用两次,或者 FROM 子句中可能包含一个没有名称的子查询,而不是表名。在这种情况下,可以在查询后指定一个任意名称,这称为别名。普通表也可以指定别名。
让我们显示“Databases”课程的学生姓名和成绩:
这里,“s”是表别名,而“ce”是子查询别名。应该选择简短而又能完整表达含义的别名。
同一个查询也可以不使用子查询来编写:
排序
如我们所知,表中的数据没有排序。要按特定顺序返回行,可以使用带有排序表达式列表的 ORDER BY 子句。在每个表达式(排序键)之后,可以指定排序方向:ASC 表示升序(默认使用),DESC 表示降序。
这里首先按成绩升序排列各行。成绩相同时,再按学生证号升序排列。如果前两个键相同,则再按课程编号降序排列。
合理的做法是在查询结束、即将返回结果之前对数据排序;子查询中通常不需要进行这项操作。
更多详情见文档:postgrespro.com/doc/sql-select#SQL-ORDERBY.
分组
使用分组时,查询会返回根据原表中存储的多行数据计算出的汇总数据。
分组通常会涉及聚合函数。例如,可以这样显示参加考试的总次数、通过考试的学生人数以及平均成绩:
如果提供包含分组键的 GROUP BY 子句,就可以按课程编号获取类似信息:
聚合函数的完整列表见 postgrespro.com/doc/functions-aggregate.
在使用分组的查询中,可能需要根据聚合结果过滤行。可以在 HAVING 子句中定义此类条件。WHERE 条件在分组前应用(可以使用原表的列),而 HAVING 条件在分组后生效(因此也可以使用结果表的列)。
让我们选出在任意课程中取得超过一次优秀成绩(5 分)的学生姓名:
更多详情见文档:postgrespro.ru/doc/sql-select#SQL-GROUPBY. (链接已修正为 PostgreSQL 17 参考文档;印刷版目标地址不可用。)
修改和删除数据
要修改表中的数据,应使用 UPDATE 语句;它会为 WHERE 子句指定的行提供新的字段值(与 SELECT 语句类似)。
例如,将“Databases”课程的授课课时数加倍:
更多详情见文档:postgrespro.com/doc/sql-update.
同样,DELETE 语句会删除 WHERE 子句指定的行:
事务
让我们稍微扩展一下数据库模式,并将学生分配到各个小组。每个小组必须有一名组长(同组学生,负责本组学生的活动)。为此,创建 groups 表:
这里应用了 NOT NULL 约束,它禁止使用未定义的值。
现在需要在 students 表中添加一列:组编号。幸运的是,可以向已经存在的表中添加新列:
使用 psql 命令,你随时可以检查表中定义了哪些列:
还可以获取数据库中所有可用表的列表:
现在创建一个名为“A-101”的新小组,将所有学生移入该小组,并让 Anna 担任组长。
注意以下细节:没有组长就无法创建小组,但学生只有已经属于该小组才能担任组长,否则数据在逻辑上就不正确且不一致。单独执行这两个操作都没有意义,必须同时完成。事务是一组构成不可分割逻辑工作单元的操作。
那么,开始事务:
接下来,需要创建一个新小组,同时指定其组长。当然,我们不可能记住所有学生的 ID,因此将把下面的查询直接放入添加新行的命令中:
提示符中的星号提醒我们,事务尚未完成。
现在打开一个新的终端窗口,再启动另一个 psql 进程:这个会话将与第一个会话并行运行。为避免混淆,我们会缩进第二个会话的命令。
第二个会话能看到第一个会话所做的更改吗?
不能,因为事务尚未完成。
继续事务,将所有学生移入新建的小组:
第二个会话仍然看到一致的数据;这些数据在未提交事务开始时已经存在于数据库中。
提交所有更改,完成事务:
最后,第二个会话收到该事务所做的全部更改,就好像它们同时出现一样:
可以保证数据库系统始终满足若干重要特性。
首先,任何事务要么完整执行(如上例),要么完全不执行。如果至少有一条命令产生错误,或者我们使用 ROLLBACK 命令中止事务,数据库就会保持在 BEGIN 命令之前的状态。这一特性称为原子性。
其次,提交事务时,所有完整性约束都必须成立,否则事务必须中止。事务开始时数据是一致的,事务结束时仍然一致,这正是该特性得名的原因:一致性。
第三,如示例所示,其他用户永远不会看到事务尚未提交的不一致数据。这一特性称为隔离性。借助这一特性,数据库系统可以同时服务多个会话,而不牺牲数据一致性。
PostgreSQL 以高效的隔离机制实现而闻名:多个会话可以并行执行读写操作,彼此不会阻塞。只有两个不同进程同时尝试修改同一行时才会发生阻塞。
最后,持久性得到保证:即使发生故障,已提交的数据也永远不会丢失(当然,前提是数据库配置正确并且定期备份)。
这些特性极其重要;很难想象没有它们的关系数据库管理系统。
要了解更多事务信息,请参阅 postgrespro.com/doc/tutorial-transactions(更多细节见 postgrespro.com/doc/mvcc)。
实用 psql 命令
\? psql 的命令行参考。
\h SQL 参考:可用命令列表或特定命令的语法。
\x 在常规表显示(行和列)与扩展显示(每列单独一行)之间切换。查看多行宽度较大的数据时很有用。
\l 数据库列表。
\du 用户列表。
\dt 表列表。
\di 索引列表。
\dv 视图列表。
\df 函数列表。
\dn 模式列表。
\dx 已安装扩展列表。
\dp 权限列表。
\d name 指定对象的详细信息。
\d+ name 指定对象的扩展详细信息。
\timing on 显示语句执行时间。
结语
我们只介绍了 PostgreSQL 所需知识的一小部分,但希望你已经发现入门并不困难。SQL 语言可以构造各种复杂程度的查询,而 PostgreSQL 则提供了高效的实现和对标准的高质量支持。请亲自尝试和实验!
还有一个重要的 psql 命令。要结束会话,请输入:
5 演示数据库
关于演示数据库
概览
要掌握更复杂的查询,我们需要创建一个规模更大的数据库(包含八张表,而不只是三张),并填入一些合理的数据。
我们选择航空公司的航班作为业务场景。数据库包含一家假想航空公司在特定时间段内所有航班的统计数据。坐过飞机的人应该都熟悉这些场景,不过我们还是会逐一说明。
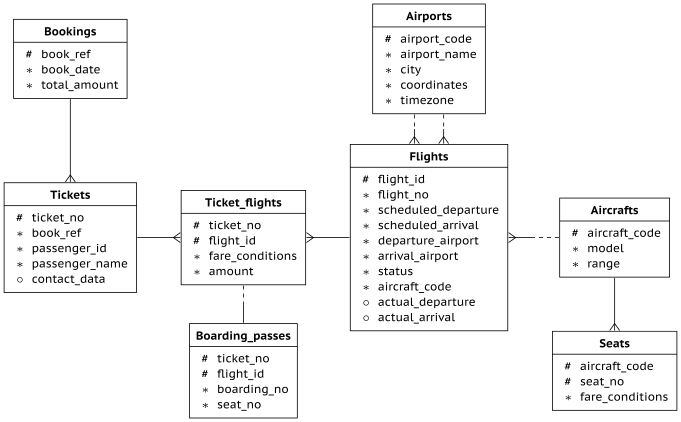
数据库模式如第 63 页所示。我们力求取得平衡:既让数据库模式保持简单,避免不必要的复杂性,又保留足够的细节,以便编写有趣且有意义的查询。
模式中的主要实体是预订(对应 bookings 表)。每次预订可以包含多名旅客,每名旅客各有一张机票(tickets)。对于旅客本人(可能多次乘坐本航空公司的航班),我们没有可靠的唯一标识符,因此没有将旅客单独建模为实体。我们将假定所有旅客都互不相同。
每张机票总是包含一个或多个航段(flight segment,ticket_flights)。如果出发机场与到达机场之间没有直达航班,或者机票是往返机票,一张机票就可能包含多个航段。
假定同一次预订中的所有机票都包含相同的航段,不过数据库模式并未设置这一约束。
每个航班(flights)从一个机场(airports)飞往另一个机场。航班号相同的航班具有相同的出发地和目的地,但出发日期不同。
办理值机时,每名旅客都会获得一张登机牌(boarding_passes),上面注明座位号。旅客只有持有该航班的机票,才能办理值机。航班与座位的组合必须唯一,以免为同一个座位签发多张登机牌。
飞机上的座位数量及其在不同舱位等级之间的分配,取决于执飞飞机的具体型号。假定每种机型只有一种客舱布局。数据库模式并不检查登机牌上指定的座位是否确实存在于该架飞机上。
接下来的各小节中,我们将介绍每张表,以及附加的视图和函数。你随时可以使用 \d+ 命令获取任意表的确切定义,包括数据类型和列说明。
预订
旅客必须提前订票。预订日期(book_date)必须在航班起飞前的一个月内。预订由预订编号标识(book_ref,由字母和数字组成的六位组合)。
total_amount 字段保存这次预订中所有旅客的机票总价。
机票
每张机票都有一个唯一编号(ticket_no),由 13 位数字组成。
机票包含旅客的身份证件号码(passenger_id)、名字和姓氏(passenger_name)以及联系信息(contact_data)。
由于旅客的证件号码或姓名可能发生变化(例如改名或换发护照),不一定能唯一识别属于同一名旅客的所有机票。为简单起见,我们假定所有旅客都互不相同。
航段
航段将机票与航班关联起来,由机票编号和航班编号共同标识。
每个航段都有价格(amount)和舱位等级(fare_conditions)。
航班
唯一标识符既可以是自然标识符(与现实中的对象相关),也可以是代理标识符(由系统生成,通常是递增的数字序列)。
flights 表的自然复合键由航班号(flight_no)和出发日期(scheduled_departure)组成。为了缩短引用该表的外键,表中使用代理键(surrogate key)flight_id 作为主键。
每个航班从一个机场(departure_airport)出发,到达另一个机场(arrival_airport)。
模式中没有“中转航班”这样的实体:如果两个机场之间没有直达航班,只需在机票中包含所有必要的航段。
每个航班都有计划起飞和到达的日期与时间(scheduled_departure 和 scheduled_arrival)。但由于延误,实际起飞和到达时间(actual_departure 和 actual_arrival)可能不同,延误可能从几分钟到几小时不等。
航班状态 status 可以取下列值之一:
Scheduled(计划中):可以预订该航班。这个值在计划出发日期前一个月设置;此时,航班信息被录入数据库。
On Time(准点):航班已开放值机(计划起飞前 24 小时),且没有延误。
Delayed(延误):航班已开放值机(计划起飞前 24 小时),但发生了延误。
Departed(已起飞):飞机已经起飞,正在空中飞行。
Arrived(已到达):飞机已经到达目的地。
Cancelled(已取消):航班已取消。
机场
机场由三个字母组成的机场代码 airport_code 标识,并具有机场名称 airport_name。
城市 city 没有单独建模为实体;城市名称只是机场的一个属性,用于识别同一城市的所有机场。表中还包含坐标 coordinates(经纬度)和时区 timezone。
登机牌
值机在计划起飞前 24 小时开放,旅客办理值机时会获得登机牌。每张登机牌由机票编号与航班编号的组合唯一标识。
登机牌编号(boarding_no)按值机顺序依次分配,仅在特定航班内唯一。登机牌还注明座位号(seat_no)。
飞机
每种机型由三个字符组成的 aircraft_code 标识。表中还包含机型名称 model,以及以千米为单位的最大航程(range)。
座位
座位定义了每种机型的客舱布局。每个座位都有编号(seat_no)及指定的舱位等级(fare_conditions):Economy(经济舱)、Comfort(舒适舱)或 Business(商务舱)。
航班视图
flights_v 视图建立在 flights 表之上。视图可以像表一样查询,但不存储数据,只是执行某个查询。以下 psql 命令显示该视图的定义和查询:
这个视图增加了以下信息:
出发机场的详细信息:
departure_airport、departure_airport_name、departure_city到达机场的详细信息:
arrival_airport、arrival_airport_name、arrival_city当地起飞时间:
scheduled_departure_local、actual_departure_local
当地到达时间:
scheduled_arrival_local、actual_arrival_local飞行时长:
scheduled_duration、actual_duration
航线视图
flights 表包含一些冗余信息,可以从中提取不依赖具体航班日期的航线信息(航班号、出发和目的地机场、机型)。
这些信息构成了 routes 视图。此外,该视图还显示 days_of_week 数组,表示每周哪些天有航班,以及计划飞行时长 duration。
“now”函数
演示数据库包含一个数据快照,类似于在某个时刻为真实系统创建的备份。例如,如果某个航班的状态为 Departed,就表示备份时飞机正在空中飞行。
快照时间保存在 bookings.now 函数中。在通常需要调用 now 函数的场合,可以在演示查询中使用这个函数。
此外,这个函数的返回值还决定了演示数据库的版本。最新版本对应 2017 年 8 月 15 日,包含该日期的数据。
安装
从网站安装
演示数据库提供三个版本,只在数据量上有所不同:
edu.postgrespro.com/demo-small-en.zip 小型数据库,包含一个月的航班数据(21 MB,数据库大小为 280 MB)。
edu.postgrespro.com/demo-medium-en.zip 中型数据库,包含三个月的航班数据(62 MB,数据库大小为 702 MB)。
edu.postgrespro.com/demo-big-en.zip 大型数据库,包含一年的航班数据(232 MB,数据库大小为 2638 MB)。
学习编写查询时,小型数据库已经足够;但如果想研究查询优化的具体问题,请选择大型数据库,这样就能看到查询在大量数据上的表现。
这些文件包含使用 pg_dump 工具创建的 demo 数据库逻辑备份。注意,如果已有一个名为 demo 的数据库,它会被删除,然后从这个备份恢复。运行脚本的用户将成为该数据库的所有者。
要在 Linux 系统上安装演示数据库,请切换到 postgres 用户,下载相应文件。例如,下载小型数据库时执行以下操作:
然后运行以下命令:
在 Windows 上,下载 edu.postgrespro.com/demo-small-en.zip 文件,双击打开压缩包,将 demo-small-en-20170815.sql 文件复制到 C:\Program Files\PostgreSQL\17 目录中。
pgAdmin 应用程序(见第 111 页)不支持从这种备份中恢复数据库。因此,应通过点击“SQL Shell (psql)”快捷方式启动 psql,运行以下命令:
如果找不到文件,请检查快捷方式的“起始位置”(Start in)属性;文件必须位于该目录中。
示例查询
略谈模式
安装完成后,启动 psql 并连接演示数据库:
bookings 模式包含所有必要的实体。连接数据库时会自动使用这个模式,因此无需显式指定:
不过,调用 bookings.now 函数时必须指定模式,以便将它与标准 now 函数区分开来:
以下查询返回城市和机场:
数据库内容提供英语和俄语两个版本。将 bookings.lang 参数分别设置为 en 或 ru,即可在两种语言之间切换。默认选择英语,可以如下更改设置:
语言已在数据库级别修改,现在需要重新连接数据库。
要了解其工作原理,可以使用 \d+ psql 命令查看 aircrafts 或 airports 的定义。(译注:原版此处指 psql 的 \d+ 命令;英文网页将命令和程序名合入了同一代码片段。)
要了解更多模式管理方面的信息,请参阅文档:postgrespro.com/doc/ddl-schemas.
设置配置参数的更多信息见 postgrespro.com/doc/config-setting.
简单查询
我们用这个模式讨论几个问题,由浅入深。大多数问题后面都给出了解答,但要有效地学习 SQL,不妨先自己编写查询,再看答案。
问题。 前天,谁乘坐了从 Moscow(SVO)飞往 Novosibirsk(OVB)的航班,座位是 1A?机票是什么时候预订的?
解答。 “前天”应根据 booking.now 的值计算,而不是根据当前日期。(译注:原版正文此处写作 booking.now,下方 SQL 使用的是 bookings.now()。)
问题。 昨天的 PG0404 航班有多少空座位?
解答。 这个问题有多种解法。其中一种是使用 NOT EXISTS 表达式,找出没有登机牌的座位:
另一种方法是通过集合差运算查找空座位。不同解法会得到相同结果,但性能有时会有所不同;如果性能很重要,就需要考虑这一点。
问题。 哪些航班的延误时间最长?列出排名前十的“佼佼者”。
解答。 查询只能包含已经起飞的航班。
也可以使用 status 列列出所有适用的状态,定义同样的条件。还可以指定 DESC NULLS LAST 排序,使未定义值排在结果末尾,从而完全省略 WHERE 条件。
聚合函数
问题。 从 Moscow 到 St. Petersburg 的各个航班,最短飞行时长是多少?延误超过一小时的次数各有多少?
解答。 解决这个问题时,使用现有的 flights_v 视图比自行连接表更方便。只能考虑已经到达的航班。
问题。 找出每次乘机都第一个办理值机的旅客。只考虑至少乘坐过两次航班的旅客。
解答。 利用登机牌编号按值机顺序分配这一事实。
问题。 一次预订可以包含多少名旅客?
解答。 我们先统计每次预订中的旅客人数,再按人数统计预订次数。
窗口函数
问题。 对于每张机票,显示它包含的所有航段以及转机时间。结果仅限一周前预订的机票。
解答。 使用窗口函数,避免两次访问同样的数据。
可以看到,航班之间的间隔时间可能长达数天:往返机票和单程机票按同样方式处理,在目的地停留的时间也被当作转机时间。“数组”一节中有一道题的解法,可以帮助你在编写查询时考虑这一点。
问题。 哪些名字与姓氏的组合最常见?具有这些姓名的旅客占旅客总数的比例是多少?
解答。 使用窗口函数计算旅客总数。
问题。 分别针对名字和姓氏求解上一道题。
解答。 我们来看看如何统计名字。统计姓氏的查询只在 p 子查询上有所不同。
从这个复杂的查询可以看出,如果需要分别使用不同的值,就应避免将它们放在同一个文本字段中;用学术术语来说,这叫第一范式。
数组
问题。 数据库并未明确标注机票是单程还是往返。不过,可以通过比较最初的出发地和最后的目的地来判断。对于每张机票,忽略转机,显示出发机场和目的地机场,并标明是否为往返机票。
解答。 一种简单的解法是使用 array_agg 函数,将行程中的机场列表转换为数组。
我们选取数组的中间元素作为目的地机场,并假定去程和回程的停靠次数相同。
在这个示例中,tickets 表只扫描一次。显示机场数组是为了便于理解;数据量较大时,最好将它从查询中移除,因为额外的数据可能影响性能。
问题。 找出去程航线与回程航线不同的往返机票。
问题。 找出去程和回程航班在一周中不同日期出发的机场对。
解答。 题目中构建每周飞行日期数组的部分,实际上已经由 routes 视图解决了。只需使用 && 操作符检查数组是否相交,并确认交集为空。
递归查询
问题。 如何以最少的转机次数从 Ust-Kut(UKX)到达 Neryungri(CNN)?飞行时间是多少?
解答。 这个问题需要找出图中的最短路径。我们将使用递归查询来完成。
这个查询的详细分步说明已发布在 habr.com/en/company/postgrespro/blog/490228/. 下面简要介绍。
查询执行过程中会构建 hops 数组,检查该数组即可避免无限循环。
由于查询执行的是广度优先搜索,找到的第一条路径的转机次数最少。为了避免遍历其他路径(它们可能很多,而且肯定比已找到的路径更长),这里使用了 found 属性。它通过 bool_or 窗口函数计算。
将这个查询与不使用 found 技巧的简化版本作比较,会很有帮助。
要了解更多递归查询方面的信息,请参阅文档:postgrespro.com/doc/queries-with.
问题。 从任意一个机场前往另一个机场,最多可能需要转机多少次?
解答。 我们可以在上一个查询的基础上求解。不过,第一次迭代现在必须包含所有可能的机场对,而不只是某一对:每个机场都要与其他所有机场配对。先求出每一对机场之间的最短路径,再从中选取最长的一条。
显然,只有航线图是连通的,才有可能这样做。我们的演示数据库满足这一条件。
这个查询也使用了 found 属性,但这里需要对每一对机场分别计算。
问题。 从飞行时间的角度,找出 Ust-Kut(UKX)到 Neryungri(CNN)的最短航线(忽略转机时间)。
解答。 为避免无限循环,我们使用 PostgreSQL 14 引入的 CYCLE 子句。
注意,这条航线的转机次数可能不是最少的。
函数与扩展
问题。 求 Kaliningrad(KGD)与 Petropavlovsk-Kamchatsky(PKC)之间的距离。
解答。 airports 表中包含机场坐标。要精确计算两点之间的距离,必须考虑地球曲率。最适合完成这项任务的是 PostGIS 扩展,它可以用大地水准面来近似地球表面。
不过,这个示例用简单的球体模型就足够了。我们使用 earthdistance,再将结果从英里转换为千米。
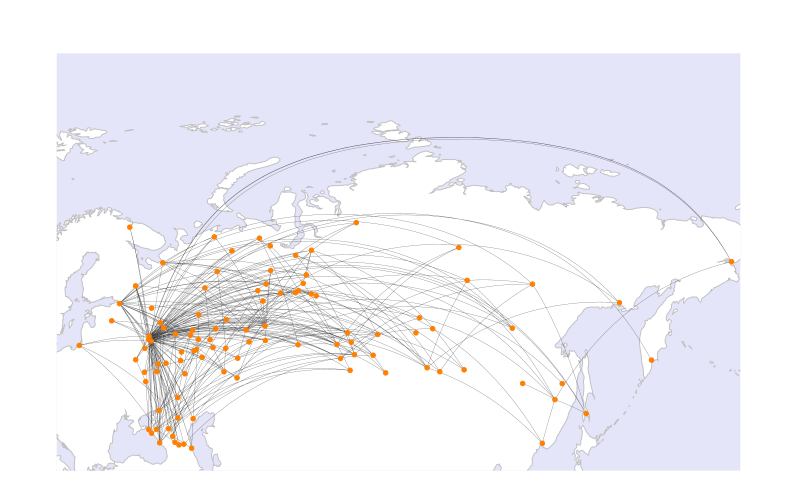
问题。 画出所有机场之间的航班图。
6 应用中的 PostgreSQL
独立的用户
上一章介绍了如何以 postgres 用户的身份连接数据库服务器。PostgreSQL 刚安装好时,数据库中只有这个用户。由于 postgres 是超级用户,应用程序不应使用它来连接数据库。更好的做法是新建一个用户,让它成为一个独立数据库的所有者,这样它的权限就会限制在这个数据库内。
有关用户和权限的详细信息,请参阅 postgrespro.com/doc/user-manag 和 postgrespro.com/doc/ddl-priv。
要以新用户的身份连接新建的数据库并开始使用,运行:
这个命令依次接受四个参数:数据库名(appdb)、用户名(app)、节点(localhost 或 127.0.0.1)和端口号(5432)。
请注意,提示符中变化的不只是数据库名:井号(#)也变成了大于号(>)。井号表示超级用户权限,类似于 Unix 中的 root 用户。
app 用户在 appdb 数据库中拥有全部权限。例如,这个用户可以创建一张表:
远程连接
在我们的示例中,客户端和数据库位于同一台计算机上。也可以将 PostgreSQL 安装到独立的服务器上,再从其他计算机(例如应用服务器)连接。在这种情况下,必须用数据库服务器的地址代替 localhost。不过,这还不够:出于安全考虑,PostgreSQL 默认只允许本地连接。
要从外部连接数据库,必须修改两个文件。
首先修改保存主要配置项的 postgresql.conf 文件。它通常位于数据目录中。
找到定义 PostgreSQL 监听哪些网络接口的这一行:
将它替换为:
接着修改保存身份验证设置的 pg_hba.conf 文件。
客户端尝试连接服务器时,PostgreSQL 会在这个文件中查找第一条与连接匹配的记录,匹配依据有四个参数:连接类型、数据库名、用户名和客户端 IP 地址。这条记录还指定用户必须如何证明自己的身份。
例如,在 Debian 和 Ubuntu 上,这个文件包含下面这项设置(最上面以井号开头的一行是注释):
这表示,以任意用户(all)身份连接任意数据库(all)的本地连接(local),都必须通过 peer 方法进行身份验证(显然,本地连接不需要 IP 地址)。
peer 方法会让 PostgreSQL 向操作系统获取当前用户名,并假定操作系统已经完成了必要的身份验证检查(提示用户输入密码)。因此,在类 Linux 操作系统上,用户连接本地服务器时通常不必输入密码。
但 Windows 不支持这种本地连接。(译注:此处照译原版;PostgreSQL 17 文档说明的是 Windows 默认不创建 Unix 域套接字,参见连接设置。)因此,这一行是这样的:
这表示,从本机地址(127.0.0.1)发起、以任意用户(all)身份连接任意数据库(all)的网络连接(host),必须使用 md5 方法进行验证。这种方法要求用户输入密码。
要允许 app 用户从任意地址访问 appdb 数据库,并要求其提供有效密码,可以在 pg_hba.conf 文件末尾加入这一行:
修改配置文件后,别忘了让服务器重新读取设置:
有关身份验证设置的详细信息,请参阅 postgrespro.com/doc/client-authentication.html。(译注:上面的重新加载步骤照录原版。修改 listen_addresses 后需要重启服务器,仅调用 pg_reload_conf() 不会使该参数生效;参见 PostgreSQL 17 连接设置。)
测试服务器连接
要在应用程序中访问 PostgreSQL,需要找到合适的库,并安装相应的数据库驱动程序。驱动程序通常是对 libpq 的封装;这个标准库实现了 PostgreSQL 的客户端—服务器协议,不过也可以采用其他实现方式。库为应用开发者提供了便捷的接口,以使用协议的底层功能。
下面几个小节给出了一些常用语言的简单代码片段,可以帮助你快速检查与已安装、配置好的数据库系统之间的连接。
这些代码片段只是最小示例,不应在生产环境中使用;它们没有任何其他功能,甚至连错误处理都没有。
如果使用 Windows,为了正确显示扩展字符集,可能需要在命令提示符窗口中切换到 TrueType 字体(例如“Lucida Console”或“Consolas”),并更改代码页。例如,要使用俄语,可以运行以下命令:
PHP
PHP 通过一个专门的扩展与 PostgreSQL 交互。在 Linux 上,除了 PHP 本身,还必须安装包含这个扩展的软件包:
Windows 版 PHP 可以从 PHP 网站下载安装:windows.php.net/download。二进制发行包已经包含 PostgreSQL 扩展,但必须在 php.ini 文件中找到下面这一行,去掉分号以取消注释:
示例程序(test.php):
运行以下命令:
PHP 文档介绍了这个 PostgreSQL 扩展:php.net/manual/en/book.pgsql.php。
Perl
在 Perl 中,数据库操作通过 DBI 接口实现。Debian 和 Ubuntu 已经预装 Perl,因此只需安装驱动程序:
Windows 版 Perl 有多种发行版本,列于 perl.org/get.html。ActiveState Perl 和 Strawberry Perl 等常见发行版本已经预装了 PostgreSQL 驱动程序。
示例程序(test.pl):
运行以下命令:
有关这个接口的说明,请参阅文档:metacpan.org/pod/DBD::Pg。
Python
Python 通常使用 psycopg 库(读作“psycho-pee-gee”)与 PostgreSQL 交互。
较新的 Debian 和 Ubuntu 版本已经预装 Python 3,因此只需添加相应的驱动程序:
Windows 版 Python 可以从 python.org 网站下载。psycopg 库可从 initd.org/psycopg 获取(请选择与已安装的 Python 版本相对应的版本)。所需的文档也都可以在那里找到。
示例程序(test.py):
运行以下命令:
Java
Java 通过 JDBC 接口访问数据库。需要安装 Java SE 11 和 JDBC 驱动程序包。
Windows 版 JDK 可以从 oracle.com/technetwork/java/javase/downloads 下载。JDBC 驱动程序可从 jdbc.postgresql.org 获取(请选择与系统中已安装的 JDK 相对应的版本)。所需的文档也都可以在那里找到。
来看一个示例程序(Test.java):
编译并执行程序,同时指定 JDBC 驱动类的路径(在 Windows 上,路径之间用分号分隔,而不是冒号):
备份
虽然我们的数据库只有一张表,保证数据的持久性仍然很重要。应用程序的数据量较小时,最简单的备份方式是使用 pg_dump 工具:
在文本编辑器中打开生成的 appdb.dump 文件,就会看到一些标准 SQL 命令,用于创建 appdb 中的所有对象,并填入数据。将这个文件传给 psql,就可以恢复数据库的内容。例如,可以创建一个新数据库,再将所有数据导入其中:
上一章介绍的演示数据库就是以这种格式分发的。
pg_dump 工具还有许多功能值得了解:postgrespro.com/doc/app-pgdump。其中有些功能只有以自定义格式导出数据时才能使用。在这种情况下,恢复数据必须使用 pg_restore 工具,而不是 psql。
无论采用哪种格式,pg_dump 都只能备份单个数据库的内容。要备份整个数据库集簇,包括全部数据库、用户和表空间,需要使用另一个命令:pg_dumpall。
大型项目需要细致、全面的备份策略。这时,更好的选择是为数据库集簇制作物理二进制副本,可以使用 pg_basebackup 工具完成:
这个命令会在 backup 目录中备份整个数据库集簇。要从备份恢复集簇,将其移至数据目录,然后重启服务器。
有关备份和恢复工具的详细信息,请参阅文档:postgrespro.com/doc/backup。
PostgreSQL 的内置功能几乎可以实现所有备份需求,但需要完成多个步骤,而且缺乏自动化。为此,许多公司都开发了自己的备份工具。Postgres Professional 也有这样的工具,名为 pg_probackup。使用它的免费版本,可以执行页级增量备份、保证数据完整性、在处理大量数据时使用并行执行和压缩,并实施多种备份策略。
完整文档见 postgrespro.com/doc/app-pgprobackup。
下一步做什么?
现在可以开始开发应用程序了。从数据库的角度看,应用程序总是由服务端和客户端两部分组成。服务端包括与数据库系统相关的一切:表、索引、视图、触发器、存储函数和存储过程。客户端则包含在数据库之外运行、并连接数据库的部分;从数据库的角度看,这部分是厚客户端还是应用服务器,并没有区别。
有一个重要问题,没有明确的答案:业务逻辑应该放在哪里?
一种常见的做法是把逻辑移出数据库,全部在客户端实现。开发者不熟悉关系型数据库系统的全部能力时,往往会这样做,因为他们更愿意依赖熟悉的东西,也就是应用代码。
在这种情况下,数据库在应用程序中就退居次要位置,只负责数据持久化,即可靠地保存数据。人们还常常用额外的抽象层隔离数据库系统,例如 ORM 工具,它能根据开发者熟悉的编程语言结构自动生成数据库查询。有时,选择这类方案是为了让应用程序可以移植到任意数据库系统。
这种做法有其存在的理由:如果系统能够运行,并满足所有业务目标,何乐而不为?
不过,这种方案也有一些明显的缺点:
数据一致性由应用程序保证。 所有必要的检查都由应用程序完成,而不依靠数据库系统保证数据一致性(这恰恰是关系型数据库系统特别擅长的事)。可以肯定,数据库中迟早会出现不一致的数据。届时,要么修正这些错误,要么让应用程序学会处理它们。如果多个应用程序共用同一个数据库,不使用数据库层面的约束来保证数据一致性,就不切实际了。
性能不尽如人意。 ORM 系统可以在数据库之上构建一个抽象层,但其生成的 SQL 查询质量颇值得怀疑。通常,它会执行多条小查询,每条单独来看都很快。这种模式只能应付数据量小、负载低的场景,在数据库一侧几乎无法优化。
应用代码变得更复杂。 使用面向应用的编程语言,无法编写出能够自动、正确转换为 SQL 的真正复杂的查询。因此,复杂的数据处理(当然,前提是确有需要)必须在应用层实现,并事先从数据库中取出全部所需数据,这又会增加网络上的数据传输。此外,数据库系统提供的扫描、连接、排序和聚合等算法经过多年改进和优化,性能必定优于应用代码。
要充分使用数据库的功能,包括完整性约束和存储过程,就必须深入理解它的能力。需要掌握 SQL 才能编写查询,还要学习一种服务端编程语言(通常是 PL/pgSQL),才能创建函数和触发器。作为回报,你将获得一个可靠的工具,它是任何信息系统架构中最重要的组成部分之一。
无论如何,业务逻辑究竟放在服务端还是客户端,需要你自己决定。我们只想提醒一句:不必走极端,答案往往在两者之间。
7 配置 PostgreSQL
基本设置
默认设置使 PostgreSQL 几乎可以在任何硬件上启动,包括配置较低的计算机。但要获得最佳性能,数据库配置必须同时考虑服务器的硬件特性和应用程序的典型负载。
这里只介绍生产级数据库系统必须考虑的部分基本设置。针对具体应用程序进行精细调优,还需要更多专业知识,可以通过 PostgreSQL 数据库管理课程来学习(见第 149 页)。
修改配置参数
要修改配置参数,可以打开 postgresql.conf 文件,找到所需参数并修改它的值,也可以在文件末尾添加一行:后写的设置会覆盖同一文件前面指定的值。
修改设置后,需要重新加载服务器配置:
现在用 SHOW 命令检查当前设置。如果参数值没有改变,就查看服务器日志:编辑文件时可能出错了。
也可以用 SQL 命令修改参数,无需手动编辑配置文件。不过,这种方式仍然需要重新加载服务器配置:
这类设置会写入 postgresql.auto.conf 文件,优先级高于主配置文件中指定的值。这种方式的优点是,新参数值会立即得到验证。
最重要的参数
定义 PostgreSQL 如何使用内存的参数尤其值得关注。
shared_buffers 参数设置 PostgreSQL 共享内存缓冲区的大小。缓冲区存放经常访问的数据,以尽量减少磁盘读取。一个合理的初始值是服务器所用内存总量的 25%。修改这个参数需要重启服务器。
effective_cache_size 的值不影响内存分配,只是提示 PostgreSQL 可以利用的缓存大小,其中包括操作系统缓存。这个值越大,就越倾向于使用索引。初始值可以设为内存的 50–75%。
work_mem 参数定义排序、连接操作中构建哈希表以及其他操作可以使用的内存量。频繁使用临时文件提示分配的内存不足,可能会降低性能。大多数情况下,应将默认的 4 MB 至少提高到原来的几倍,但要注意不要超出服务器的内存总量。
maintenance_work_mem 参数定义为维护进程分配的内存量。较大的值可以加快索引创建和清理的速度。这个参数通常设为 work_mem 的几倍。
例如,对于拥有 32 GB 内存的服务器,可以先采用以下设置:
random_page_cost 与 seq_page_cost 的比值必须与磁盘随机访问和顺序访问的速度之比相匹配。默认假定随机访问的耗时是顺序访问的四倍,这很适合普通机械硬盘。对于磁盘阵列和 SSD,降低 random_page_cost 可能会提高性能。不过,seq_page_cost 应保持为 1。(译注:本段照译原版。两项参数表示规划器估算的页面读取代价,它们的比值不能直接等同于访问速度之比;默认值还考虑了缓存命中。参见 PostgreSQL 17 规划器代价常量。)
例如,以下设置适用于 SSD:
配置自动清理(autovacuum)非常重要。这个进程执行“垃圾回收”和其他几项关键系统任务。具体设置很大程度上取决于应用程序及其负载。
大多数情况下,可以先采用以下配置:
将
autovacuum_vacuum_scale_factor降到 0.01,让自动清理更频繁地运行,每次处理更少的数据。将
autovacuum_vacuum_cost_limit提高到原来的 10 倍(或将autovacuum_vacuum_cost_delay降到原来的十分之一),以加快自动清理(适用于 11 及更早版本)。
正确配置与缓冲区缓存和 WAL 维护相关的进程同样重要,但具体设置也取决于应用程序。起初,可以将 checkpoint_completion_target 设为 0.9,以分散负载;将 checkpoint_timeout 从 5 分钟提高到 30 分钟,以减少检查点带来的开销;并按比例提高 max_wal_size,目的同样是减少开销。
有关各类参数的配置技巧,可以通过 DBA2 课程学习(第 154 页)。
连接设置
正如“应用中的 PostgreSQL”一章(第 89 页)所述,通常应将 listen_addresses 参数设为 '*',并修改 pg_hba.conf 配置文件以允许连接。
错误的建议
有时会看到一些提高性能的建议,但以下建议绝不应采纳:
- 关闭自动清理。
这种“节省资源”的做法可能会在短期内带来少许性能提升,但会导致数据碎片以及表和索引膨胀。数据库系统迟早会无法正常工作。绝不应该关闭自动清理,而应正确配置它。
- 关闭磁盘同步(
fsync= off)。
关闭 fsync 确实能显著提高性能,但服务器一旦崩溃(无论由软件还是硬件故障引起),就会导致所有数据库完全丢失。届时只能从备份恢复系统——前提是你恰好有备份。(译注:这里保留了原版的绝对化表述。PostgreSQL 17 文档说明的风险是:断电或系统崩溃时,可能出现无法恢复的数据损坏。参见 fsync 参数说明。)
PostgreSQL 与 1C 解决方案
1C 是一款广泛使用的俄罗斯 ERP 系统,官方支持 PostgreSQL。与购买昂贵的商业数据库许可相比,使用 PostgreSQL 是一种经济实惠的选择。
和其他应用程序一样,适当配置 PostgreSQL 能让 1C 产品运行得快得多。此外,要让 1C 达到最佳性能,还需要设置一些特定的服务器参数。
下面给出一些安装和设置说明,帮助你开始使用。
选择 PostgreSQL 版本
1C 需要经过定制补丁修改的 PostgreSQL 版本。可以从 releases.1c.ru 下载,也可以使用 Postgres Pro Standard 或 Postgres Pro Enterprise;它们同样包含所有必需的补丁。
PostgreSQL 也能在 Windows 上运行,不过如果可以选择,最好使用 Linux 发行版。
安装前,需要决定是否使用专用数据库服务器。专用服务器能更好地平衡应用服务器与数据库服务器之间的负载,因此性能更高。
配置参数
服务器的硬件规格必须与预期负载相匹配。可以参考以下基准:对于 100 GB 的数据库、总计 50 名用户、每天最多 2,000 份单据,一台配备 8 核处理器、8 GB 内存和 RAID1 SSD 磁盘子系统的专用服务器应当足够。如果不是专用服务器,PostgreSQL 也必须从共用服务器中获得相应的资源。
结合通用建议和 1C 应用的要求,建议这类服务器采用以下初始设置:
连接设置
确保 postgresql.conf 文件中的 listen_addresses 参数设为 *。
在 pg_hba.conf 配置文件开头加入以下一行,用实际地址和子网掩码替换“IP-address-of-the-1C-server”占位符:
重启 PostgreSQL 后,pg_hba.conf 和 postgresql.conf 文件中的所有修改都会生效,服务器即可接受 1C 的连接。
1C 使用超级用户建立连接,通常是 postgres。为这个角色设置密码:
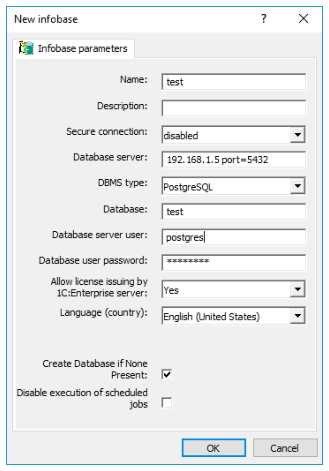
在 1C 信息库(infobase)的配置设置中,将 PostgreSQL 服务器的 IP 地址和端口填入数据库服务器字段,并将所需的 DBMS 类型选为“PostgreSQL”。指定供 1C 使用的数据库名称,勾选“Create database if none present”(数据库不存在时创建)复选框,不要通过 PostgreSQL 自带的工具创建这个数据库。填写用于建立连接的超级用户角色名称和密码。
这些建议应该能帮助你快速上手,但不能保证获得最佳性能。
感谢 Infosoft 公司的 Anton Doroshkevich 协助我们整理这些建议。
8 pgAdmin
pgAdmin 是广泛使用的 PostgreSQL 数据库图形化管理工具。它简化了常见的数据库管理任务,提供了浏览数据库对象的界面,还允许用户执行 SQL 查询。
多年来,pgAdmin 3 一直是 PostgreSQL 管理工具的事实标准。不过,2016 年,EnterpriseDB 停止支持 pgAdmin 3,并推出 pgAdmin 4。新版本使用 Python 和现代 Web 技术完全重写,取代了原来的 C++ 实现。pgAdmin 4 刚推出时,重新设计的界面引来了褒贬不一的评价。随着持续开发,它有了显著改进,变得更加稳健,功能也更加丰富。
安装
要在 Windows 上运行 pgAdmin 4,请使用 pgadmin.org/download 提供的安装程序。安装过程很简单,通常使用默认选项就够了。
在 Debian 和 Ubuntu 上,先添加 PostgreSQL 软件仓库(见第 30 页),然后用以下命令安装 pgAdmin 4:
随后,可用程序列表中会出现“pgAdmin4”。
这个程序的用户界面已完整本地化为十二种语言。要切换语言,点击 Configure pgAdmin(配置 pgAdmin),在设置窗口中选择 Miscellaneous > User language(杂项 > 用户语言),然后在网页浏览器中重新加载页面。
连接服务器
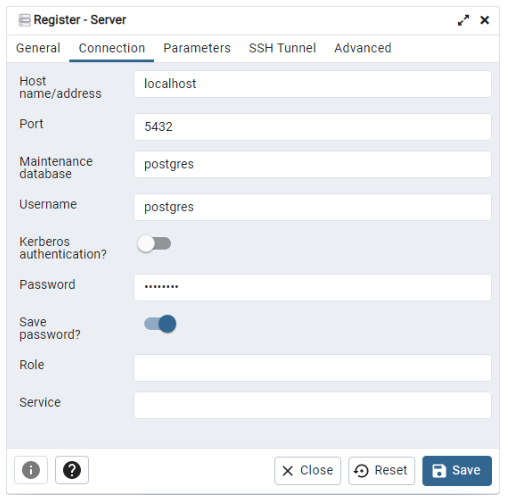
首先设置服务器连接。点击 Add New Server(添加新服务器)按钮,在弹出窗口的 General(常规)选项卡中,为连接任取一个名称。
在 Connection(连接)选项卡中,输入主机名或地址、端口号、用户名和密码。
如果不想每次都输入密码,可以勾选 Save password(保存密码)。pgAdmin 会使用主密码加密保存的密码,首次使用时会提示你设置主密码。
注意,这个用户必须已经设有密码。例如,对于 postgres 用户,可以用下面的命令设置密码:
点击 Save(保存),验证服务器连接并将它加入 pgAdmin。
对象浏览器(Browser)
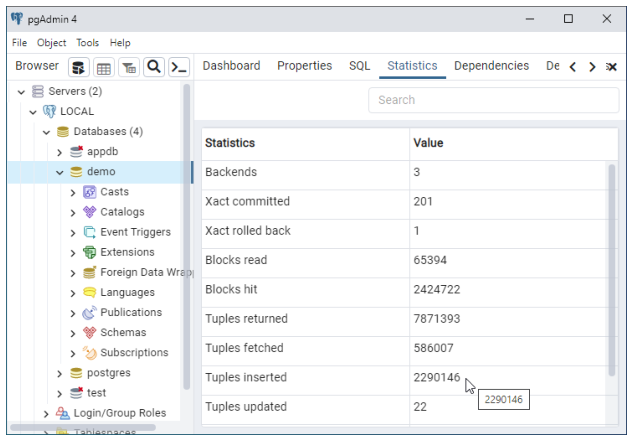
左侧窗格显示对象浏览器(Browser)的树形结构。展开后可以看到服务器,本例中名为 LOCAL。再展开一层,就能看到它的所有数据库:
appdb是为了测试用不同编程语言连接 PostgreSQL 而创建的。demo是我们的演示数据库。postgres总是在安装 PostgreSQL 时创建。test在“体验 SQL”一章(第 35 页)中使用过。
展开 appdb 下的 Schemas(模式)部分,可以看到 greetings 表,以及它的列、约束、索引和触发器。(译注:原版此处写作 greetings,第 6 章示例创建的表名是 greeting。)
右键打开的上下文菜单为各类对象提供了多种操作,包括导出、导入、分配权限和删除。
右侧窗格有几个选项卡,用于显示参考信息:
Dashboard(仪表盘)提供系统活动图表。
Properties(属性)显示在对象浏览器(Browser)中选中的对象的属性,例如列的数据类型。
SQL 显示用于创建所选对象的 SQL 命令。
Statistics(统计信息)列出查询优化器生成查询计划所用的信息;数据库管理员可以据此分析问题。
Dependencies, Dependents(依赖对象、依赖此对象的对象)展示所选对象与数据库中其他对象之间的依赖关系。
运行查询
要执行查询,在菜单中选择 Tools > Query Tool(工具 > 查询工具),打开一个新的 SQL 编辑器选项卡。
在编辑器中输入查询,按 F5 执行。底部面板的 Data Output(数据输出)选项卡会显示查询结果。
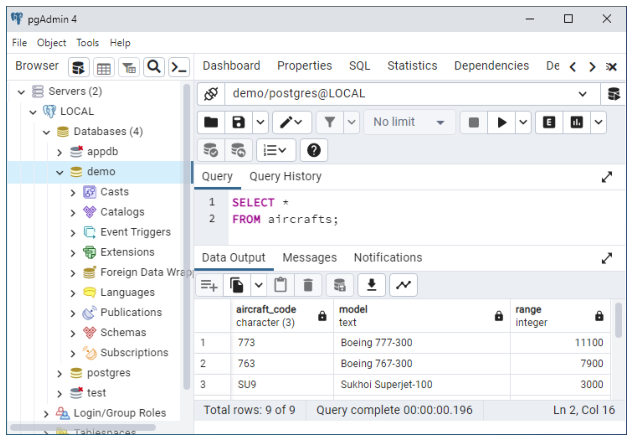
要执行新查询而不删除之前的查询,可以先选中需要执行的 SQL 片段,再按 F5。这样,完整的操作历史始终可见,通常比到 Query History(查询历史)选项卡的日志中查找所需查询更方便。
其他功能
pgAdmin 为 PostgreSQL 的标准工具、系统目录信息、管理函数和 SQL 命令提供了图形用户界面。它还内置了 PL/pgSQL 调试器,用于排查存储过程中的问题。可以通过产品网站 pgadmin.org 或 pgAdmin 内置的帮助系统了解它的各项功能。
9 其他特性
全文检索
全文检索是指搜索用自然语言写成的文档,并按与搜索查询的相关性对结果排序。在最简单、最常见的情况下,查询由一个或多个词组成,相关性则由这些词在文档中出现的频率决定。这大致就是我们在 Google 或 Yandex 搜索引擎中输入短语时发生的事情。不过,SQL 虽然功能强大,却并不总能有效地处理数据。随着大数据的兴起,这一点越来越明显:大数据往往结构不规整,也很难解析。
有许多免费或收费的搜索引擎,可以为整个文档集合建立索引,并提供质量相当不错的搜索。这时,索引这个加速查询的关键搜索工具独立于数据库之外,许多有价值的数据库功能也就无法使用了:数据库同步、事务隔离、通过访问和使用元数据来限定搜索范围、设置访问策略,等等。
面向文档的数据库管理系统通常也有类似的缺点:全文检索功能丰富,但数据安全和同步功能的优先级较低。此外,这类数据库(例如 MongoDB)通常属于 NoSQL 数据库,因此从设计上就缺少 SQL 多年来积累的强大能力。
不过,传统 SQL 数据库系统也内置了全文检索能力。LIKE 操作符是标准 SQL 语法的一部分,但它的灵活性往往不够,因此开发者不得不自行扩展 SQL 标准。在 PostgreSQL 中,这些扩展包括比较操作符 ILIKE、~ 和 ~*。但它们也无法解决所有问题:不考虑词形变化、不适合对结果进行排名,而且速度较慢。
谈到全文检索本身的工具,需要明白,它们远未实现标准化:各个数据库系统都有自己的方法和语法。俄罗斯的 PostgreSQL 用户在这方面有一些优势:PostgreSQL 的全文检索扩展由俄罗斯开发者创建,必要时可以直接联系专家,甚至参加他们的讲座,深入了解底层细节。这里只给出一些简单的示例。
为了了解全文检索的功能,我们将在演示数据库中再建一张表。假设表中保存一位讲师的讲义草稿,按授课主题分成章节:
现在为 CS301 和 CS305 两门课程录入前几讲的文本:
检查结果:
接下来,用传统的 SQL 方法(LIKE 操作符)在数据库中查找一些信息:
结果不难猜到:0 行。LIKE 操作符无法识别“fascination”与文本中“fascinating”和“fascinated”之间的联系。
下面的查询
会返回第 II 章的那一行,却不会返回使用了形容词“fascinating”的第 I 章:
PostgreSQL 提供了 ILIKE 操作符,让我们不必考虑字母大小写;否则,还得把大小写的区别考虑进去。当然,也可以使用正则表达式(搜索模式)。编写正则表达式的确很有趣,几乎称得上是一门艺术,但有时我们只是想要一个能把事情办好的工具。因此,给 course_chapters 表再加一列,使用一种名为 tsvector 的特殊类型:
可以看到,这些行发生了变化:
单词被归约为词根形式,即词位(lexeme)。
出现了数字,用来表示单词在文本中的位置。
介词被去掉了;连词和其他对搜索不重要的句子成分也会被去掉,这些词称为停用词(stop words)。
如果把章节标题也纳入搜索,并赋予它比正文更高的权重,搜索效果会更好;可以用 setweight 函数做到这一点。修改表中的数据:
我们为词位分配了相对权重标记 B 和 D,可选标记有 A、B、C、D。具体权重将在编写查询时指定,这样更灵活。
准备就绪,回到搜索。to_tsquery 函数与前面见过的 to_tsvector 函数类似,它将字符串转换为查询使用的 tsquery 数据类型。
可以验证,查询 'fascinated & database' 及其其他词形变体会返回相同的结果。这里使用了比较操作符 @@,它在全文检索中的作用类似于 LIKE 在普通搜索中的作用。@@ 操作符的语法不允许包含空格的自然语言表达式,因此查询中的词用逻辑“与”操作符连接。(译注:这里的限制实际来自 to_tsquery 的输入语法;它要求词位之间使用 & 等查询操作符。若要处理自然语言文本,可使用 plainto_tsquery()。)
english 参数表示 PostgreSQL 使用的配置。配置定义要接入的词典和解析器;解析器把短语拆成单独的词位。
词典虽然叫作“词典”,但可以完成各种词位转换。例如,默认使用的 snowball 这类简单词干提取词典会把单词归约为不变的部分,使搜索能够忽略查询中的词尾变化。还可以接入其他词典,例如:
ispell、myspell或hunspell等常规词典,能更好地处理词形变化同义词词典
词组词典(thesaurus)
unaccent,可以去掉字母上的变音符号
分配权重后,就可以对显示的搜索结果排名:
数组 {0.1, 0.0, 1.0, 0.0} 设置权重,是 ts_rank_cd 函数的可选参数。默认数组 {0.1, 0.2, 0.4, 1.0} 依次对应 D、C、B、A。单词的权重会影响返回行的排名。
最后一个实验来修改显示格式。假设我们希望在 HTML 页面中用粗体突出显示找到的词。ts_headline 函数可以指定突出显示单词所用的符号,并设置一行中显示的最少和最多单词数:
为了加快全文检索,可以使用不同于常规数据库索引的专用索引:GiST、GIN 和 RUM。不过,与全文检索的许多其他实用功能一样,这些内容超出了本指南的范围。
有关全文检索的更多信息,请参阅文档:www.postgrespro.com/doc/textsearch。
使用 JSON 与 JSONB
基于 SQL 的关系型数据库在设计之初就非常重视数据一致性和安全性,当时的数据量远小于今天。NoSQL 数据库出现时,曾引起社区的担忧:不支持严格一致性,加上简单得多的数据结构(最初只是存储键值对),使搜索速度显著提升。它们大量使用并行计算,能够处理前所未有的信息量,而且容易扩展规模。
最初的冲击过后,人们逐渐意识到,这样简单的结构不足以应对大多数实际任务。于是先有了复合键,接着又出现了键组。为了保持竞争力,关系型数据库系统也开始引入通常与 NoSQL 联系在一起的功能。
在关系型数据库中修改数据库结构代价很高,这时新的 JSON 数据类型就派上了用场。它具有类似 XML 的层次结构,最初面向 JavaScript 开发(这也是名称中 JS 的由来),包括 AJAX 应用开发。JSON 的灵活性使开发者可以存储和管理结构动态变化、难以预知的数据,而不必修改数据库结构。
假设需要在 students 演示数据库中录入个人信息。我们开展了一次调查,从教授那里收集信息。问卷中有些问题是选答题,另一些问题包含“请自行补充信息”和“其他”字段。如果采用传统方法,那些不符合现有结构的信息就需要新增许多表和列,其中会留下大量空字段。随着数据集增长,甚至可能需要重构整个数据库。(译注:原版称 students 为演示数据库;本例的 SQL 显示,students 实际是 test 数据库中的表。正文名称按原版保留。)
使用 json 或 jsonb 类型可以解决这个问题。jsonb 比 json 出现得晚,以紧凑的二进制形式存储数据;与 json 不同,它支持索引,有时能将搜索速度提高一个数量级。
创建一张包含 JSON 对象的表:
检查数据是否正确插入。新表中没有学生姓名,为方便查看,使用 WHERE 子句连接 student_details 和 students 两张表:
假设我们关心的是包含学生优点信息的记录。用特殊操作符 ->> 访问“merits”键的值:
结果中的两条记录分别涉及 Anna 和 Nina 的优点,但这个结果具有误导性,因为 Anna 的优点实际上是“none”(无)。修改查询:
新查询只会返回 Nina,她确实有优点。
不过,这种方法并不总是有效。试着查询 Victor 弹奏的吉他:
这个查询不会返回任何结果,因为相应的键值对位于 JSON 层次结构内部,嵌套在更高层的键值对中:
要取出吉他列表,可以使用 #> 操作符,从“hobbies”开始沿层次结构向下查找:
可以看出,Victor 是 Fender 的爱好者:
json 有个小兄弟:jsonb。字母“b”表示数据采用二进制而非文本格式存储和组织,这通常能加快搜索。如今,jsonb 的使用频率远高于 json。
除了表示形式不同,值的顺序也变了:缺少补充信息的 Alex 现在排在 Mark 前面。这并不意味着 jsonb 不如 json,只是它的数据存储方式不同。
与 json 相比,jsonb 支持更多操作符。其中很有用的一个是“包含”操作符 @>,其工作方式类似于 json 的 #> 操作符。(译注:原版将两者并称为工作方式类似;按 PostgreSQL 17 文档,@> 用于判断 JSON 包含关系,#> 用于按路径提取 JSON 子对象。正文按原版保留。)
例如,查找提到了 Lucie 的记录,她是那位母亲的五个孩子之一:
这里使用了 jsonb_pretty() 函数来格式化 jsonb 类型的输出。
也可以使用 jsonb_each() 函数展开键值对:
注意,查询中用空的 {} 替代了 Nina 孩子的名字。这种语法让应用开发更加灵活。
更重要的是,jsonb 允许创建支持 @>、其逆操作符 <@ 以及许多其他操作符的索引,其中 GIN 索引通常最有效。json 类型不支持索引,因此,对于高负载应用,通常建议使用 jsonb。(译注:原版列出了 <@;PostgreSQL 17 文档对默认 jsonb_ops GIN 操作类列出的操作符包括 ?、?|、?&、@>、@? 和 @@,未将 <@ 列入其中。正文按原版保留。)
有关 json、jsonb 数据类型及相关函数的更多信息,请参阅 PostgreSQL 文档:postgrespro.com/doc/datatype-json 和 postgrespro.com/doc/functions-json。
SQL:2016 标准发布时,其中包含 SQL/JSON Path 语言。Postgres Professional 开发了相应实现,提供了 jsonpath 类型,后来合入 PostgreSQL 12。
$.a.b.c取代了 PostgreSQL 11 及更早版本中必须使用的'a'->'b'->'c'语法。$符号表示当前上下文元素,即需要解析的 JSON 片段。@表示过滤表达式中的当前上下文元素。搜索会遍历$表达式中所有可用的路径。*是通配符。在带有$和@的表达式中,它表示遵循层次结构的路径上的任意值。**是通配符,可以在带有$或@的表达式中表示路径的任意部分,而不考虑层次结构。不知道元素的确切嵌套层级时,它很有用。
?操作符用于创建类似于WHERE的过滤条件,例如$.a.b.c ? (@.x > 10)。
要用 jsonb_path_query() 函数查找 cosplay 爱好者,可以写出以下查询:
这个查询只搜索以“hobbies”键开头的 JSON 分支,检查相应的值是否等于“cosplay”。但如果把“cosplay”换成“guitarist”,查询就不会返回任何结果,因为在表中“guitarist”是键,而不是嵌套元素的值。
查询可以在两个层次上操作:一是在路径表达式中定义搜索范围,二是在过滤表达式中用指定条件匹配结果。因此,同一个目标可以用不同方法实现。
例如,以下查询
和下面的查询
会返回相同的结果:
在第一个示例中,我们为“hobbies.guitarist.band”分支中的每一项定义了过滤表达式。查看 JSON 本身可知,这个分支只有一个值:“Postgressors”,所以实际上没什么可过滤掉的。第二个示例的过滤发生在高一层的位置,因此必须在过滤表达式中指定到“乐队”的路径,否则过滤器就找不到任何值。使用这种语法,需要事先知道 JSON 的层次结构。如果不知道呢?
这时可以使用 ** 通配符,它非常实用!假设我们不确定“Strat”是什么:高空气球、吉他,还是社会最上层的一员,但需要知道表中到底有没有这个词。以前,这需要在 JSON 文档中进行复杂的搜索,除非把 jsonb 转成文本。现在,只需运行以下查询:
有关 SQL/JSON Path 功能的更多信息,请参阅文档(postgrespro.com/doc/datatype-json#DATATYPE-JSONPATH)以及文章“JSONPath in PostgreSQL: committing patches and selecting apartments”(在 PostgreSQL 中使用 JSONPath:提交补丁与挑选公寓)(habr.com/en/company/postgrespro/blog/500440/)。
SQL:2016 标准还定义了一些便于处理 JSON 的功能和表达式,它们也在逐步进入 PostgreSQL。这里介绍其中一部分,完整列表请参阅文档:postgrespro.com/doc/functions-json。
回到我们的朋友 Anna、Victor 和 Nina。他们参加了一次调查,了解年轻一代喜欢哪些电视剧,结果保存在一张表中。
s_id int REFERENCES students(s_id),
数据库工程师来分析这些结果。他们有一套强大的工具:聚合函数、检查约束,以及各种 json(b) 工具。
首先应把数组拆成单独的元素(unnest)。可以用 jsonb_array_elements 完成,但有一个问题:
果然,问卷数据录入数据库时不够仔细:学生 1432 对应的数据不是数组,虽然只有一个元素,也应该是数组。用 IS [NOT] JSON ARRAY 确认一下:
可以用 jsonb_set 修正类型,它能够修改 jsonb 的结构:
现在:
这就是最终列表。注意,IS JSON ARRAY 与 IS JSON SCALAR、IS JSON OBJECT 以及更通用的 IS JSON 属于同一组谓词。详情请参阅文档:postgrespro.com/doc/functions-json。
与外部系统集成
现实中的应用程序并不孤立,往往需要相互传递数据。可以在应用层实现这种交互,例如使用 Web 服务或交换文件,也可以依靠数据库功能来完成。
PostgreSQL 支持 ISO/IEC 9075-9 标准,即 SQL/MED(外部数据管理)。该标准定义了通过外部数据包装器(foreign data wrapper,FDW)这一专用机制,从 SQL 访问外部数据源的方法。
其思路是像访问普通 PostgreSQL 表中的数据一样访问外部数据。为此需要创建外部表;外部表本身不存放数据,只将所有查询转发给外部数据源。这种方式屏蔽了各个外部数据源的具体差异,方便了应用开发。
创建外部表需要几个步骤。
CREATE FOREIGN DATA WRAPPER命令接入用于操作特定数据源的库。CREATE SERVER命令定义外部服务器。通常需要指定主机名、端口号和数据库名等连接参数。CREATE USER MAPPING命令提供用户名映射,因为不同的 PostgreSQL 用户可以用不同外部用户的身份连接同一个外部数据源。CREATE FOREIGN TABLE命令为指定的外部表和视图创建外部表;IMPORT FOREIGN SCHEMA则可以从外部模式导入部分或全部表的定义。
下面介绍 PostgreSQL 如何与最常用的几种数据库集成:Oracle、MySQL、SQL Server,以及 PostgreSQL 自身。首先需要安装访问这些数据库所需的库。
安装扩展
PostgreSQL 发行版包含两个外部数据包装器:postgres_fdw 和 file_fdw。前者用于访问外部 PostgreSQL 数据库,后者用于访问服务器上的文件。此外,社区还开发和维护了多种库,用于访问许多常见数据库。完整列表见 pgxn.org/tag/fdw。
Oracle、MySQL 和 SQL Server 的外部数据包装器以扩展的形式提供:
Oracle — github.com/laurenz/oracle_fdw
SQL Server — github.com/tds-fdw/tds_fdw
按照这些网页上的说明编译并安装扩展。如果一切顺利,就能在可用扩展列表中看到相应的外部数据包装器。例如,查看 oracle_fdw:
Oracle
首先创建扩展,它会添加一个外部数据包装器:
检查相应的包装器是否已经添加:
下一步是设置外部服务器。在 OPTIONS 子句中,必须指定 dbserver 选项,给出 Oracle 实例的连接参数:服务器名、端口号和实例名。
PostgreSQL 用户 postgres 将以 scott 的身份连接 Oracle 实例。
我们把外部表导入一个独立的模式。先创建模式:
接着导入外部表。这里只导入两张常见的表,dept 和 emp:
注意,Oracle 数据字典以大写形式保存对象名,而 PostgreSQL 系统目录以小写形式保存。在 PostgreSQL 中访问外部数据时,必须用双引号括起大写的 Oracle 模式名,避免它被转换为小写。
查看外部表列表:
现在对外部表执行以下查询,访问外部数据:
也可以写入外部数据:
MySQL
为所需的外部数据包装器创建扩展:
用 host 和 port 参数定义连接外部实例的外部服务器:
我们将以 MySQL 超级用户的身份建立连接:
这个包装器支持 IMPORT FOREIGN SCHEMA 命令,不过也可以手动创建外部表:
检查结果:
和 Oracle 包装器一样,mysql_fdw 同时支持读写操作。
SQL Server
为所需的外部数据包装器创建扩展:
创建外部服务器:
所需的连接信息相同,仍要提供主机名、端口号和数据库名。不过,OPTIONS 子句使用的参数与 oracle_fdw 和 mysql_fdw 不同。
我们将以 SQL Server 超级用户的身份建立连接:
为外部表创建一个独立的模式:
将整个 HumanResources 模式导入新建的 PostgreSQL 模式:
可以用 \det 命令显示导入的表,也可以运行以下查询,从系统目录中查找它们:
对象名区分大小写,因此在 PostgreSQL 查询中应使用双引号括起来:
目前,tds_fdw 只支持读取,不允许写入。
PostgreSQL
创建扩展和包装器:
这次要连接同一服务器实例中的另一个数据库,因此创建外部服务器时只需提供 dbname 参数,其他参数(例如 host、port 等)可以省略。
在同一个数据库集簇内创建用户映射时,不必指定密码:(译注:本例使用 postgres 超级用户;是否需要密码取决于用户映射、认证配置和连接方式,不能仅凭位于同一数据库集簇就断定无需密码。)
导入 bookings 模式中的所有表和视图:
检查结果:
有关 postgres_fdw 的更多信息,请参阅文档:postgrespro.com/doc/postgres-fdw。
外部数据包装器还值得一提,因为社区认为它们是 PostgreSQL 内置分片功能的基础。分片与分区类似,都是按某种条件把表拆成独立存储的多个部分。区别在于,分区保存在同一台服务器上,分片则位于不同服务器。PostgreSQL 很早就支持分区。从版本 10 开始,分区机制一直在积极发展,已经加入许多实用功能:声明式语法、动态分区剪枝、并行操作支持以及其他多项改进。也可以把外部表用作分区,这实际上就把分区变成了分片。
不过,要让分片完全实用,仍有大量工作要做:
- 无法保证一致性:访问外部数据时使用的是各自独立的本地事务,而不是单一的分布式事务。
无法在不同服务器上复制同一份数据来提高容错性。
在各分片上创建表以及创建相应外部表的所有操作,都必须手动完成。
Postgres Professional 开发的新工具 Shardman 已经解决了这些问题(postgrespro.ru/products/shardman)。
发行版还包含另一个用于访问 PostgreSQL 数据库的扩展:dblink。它允许显式管理连接(连接和断开)、执行查询,并异步获取结果:postgrespro.com/doc/dblink。
10 教育与认证
文档
阅读文档对于专业使用 PostgreSQL 不可或缺。文档介绍数据库的全部功能,并提供一份应始终随手可查的详尽参考。在这里,你可以直接获得完整而准确的信息:文档由开发者亲自编写,并始终认真保持最新。PostgreSQL 文档见 www.postgresql.org/docs 或 postgrespro.com/docs。
Postgres Professional 已将整套 PostgreSQL 文档(包括最新版本)翻译成俄文,见其网站:postgrespro.ru/docs。
在翻译过程中,我们还编制了英俄术语表,发布于 postgrespro.ru/education/glossary。将英文文章翻译成俄文时,建议查阅这份术语表,以使用广大读者熟悉且保持一致的术语。
此外,各国社区还提供了法文(docs.postgresql.fr)、日文(www.postgresql.jp/document)和中文(postgres.cn/docs)翻译。
培训课程
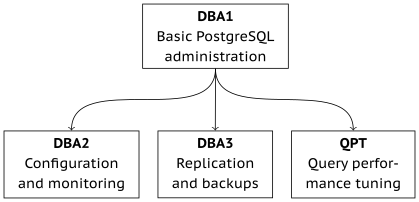
我们为刚开始使用 PostgreSQL 或希望提升专业技能的人开发培训课程。
数据库管理员课程:
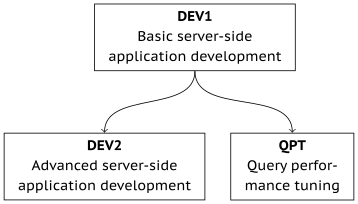
应用开发者课程:
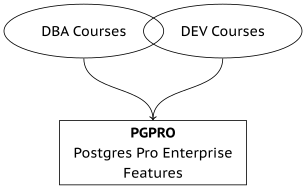
为完成管理和开发课程的人员提供的一门关于我们主要产品的附加课程:
PostgreSQL 和 Postgres Pro 文档包含 PostgreSQL 的所有细节,但信息往往分散在不同章节中,因此需要仔细阅读数遍才能完全理解。
培训课程旨在补充文档,而不是取代文档。课程由相互独立的模块组成,逐步讲解特定主题,重点介绍重要的实践信息。课程可以拓宽视野、整理此前获得的零散知识,并帮助你在需要快速查找某个细节时熟悉文档的组织方式。
每个课程主题都包括理论与实践。多数情况下,理论部分既包括幻灯片,也包括在真实系统上的现场演示。学员会收到带有大量注释的全部课程幻灯片、演示脚本的输出、实践作业的解答,以及某些主题的额外参考资料。
培训地点和方式
非商业使用和自学时,包括视频在内的全部课程材料都可在我们的网站上免费获取。俄文版本见 postgrespro.ru/education/courses。
目前已经翻译成英文的课程发布在 postgrespro.com/community/courses。
你也可以在专业培训中心参加这些课程,由经验丰富的讲师指导。完成课程后,你将获得结业证书。授权培训中心列表见 postgrespro.ru/education/where。
DBA1:PostgreSQL 基础管理
学习时长:3 天
所需背景知识:
具备数据库和 SQL 基础知识,熟悉 Unix。
获得的知识与技能:
了解 PostgreSQL 架构;安装、初始设置和服务器管理;逻辑结构与物理数据布局;基本管理任务;用户与访问管理;备份、恢复和复制。
主题:
基础工具
- 安装和服务器管理
- 使用 psql
- 配置
架构
- PostgreSQL 概览
- 隔离与多版本并发控制
- 清理
- 缓冲区缓存与预写式日志
数据管理
- 数据库与模式
- 系统目录
- 表空间
- 底层原理
管理任务
- 监控
访问控制
- 角色与属性
- 权限
- 行级安全
- 连接与身份验证
备份
- 概览
复制
- 概览
英文课程材料可在 postgrespro.com/community/courses/DBA1 免费获取,用于自学。
DBA2:配置和监控 PostgreSQL
学习时长:4 天
所需背景知识:
SQL 基础。熟练使用 Unix 操作系统。在 DBA1 课程范围内熟悉 PostgreSQL。
获得的知识与技能:
基于对服务器内部机制的理解设置各种配置参数。监控服务器活动,并利用收集的数据反复调优 PostgreSQL 配置。配置本地化设置。管理扩展并开始进行服务器升级。
主题:
多版本并发控制
- 事务隔离
- 页与行版本
- 数据快照
- HOT 更新
- 清理
- 自动清理与元组冻结
日志
- 缓冲区缓存
- 预写式日志
- 检查点
- WAL 配置
锁
- 对象锁
- 行级锁
- 内存锁
管理任务
- 管理扩展
- 本地化
- 服务器升级
俄文课程材料可在 postgrespro.ru/education/courses/DBA2 免费获取,用于自学。
DBA3:复制与备份
学习时长:2 天
所需背景知识:
SQL 基础。熟练使用 Unix 操作系统。在 DBA1 课程范围内熟悉 PostgreSQL。
获得的知识与技能:
进行备份;设置物理复制和逻辑复制;识别复制的适用场景;了解集群技术。
主题:
备份
- 逻辑备份
- 基础备份
- WAL 归档
复制
- 物理复制
- 切换到副本
- 逻辑复制
- 使用场景
集群技术
- 概览
俄文课程材料可在 postgrespro.ru/education/courses/DBA3 免费获取,用于自学。
DEV1:基础服务器端应用开发
学习时长:4 天
所需背景知识:
SQL 基础。具备任意过程式编程语言的使用经验。具备 Unix 操作系统基础知识。
获得的知识与技能:
了解 PostgreSQL 架构概况。使用主要数据库对象。在服务器端使用 SQL 和 PL/pgSQL 编程。使用主要数据类型,包括记录和数组。设置客户端与服务器之间的通信通道。
主题:
基础工具
- 安装和服务器管理、psql
架构
- PostgreSQL 概览
- 隔离与 MVCC
- 缓冲区缓存与 WAL
数据组织
- 逻辑结构
- 物理结构
书店应用
- 应用模式与接口
SQL
- 函数
- 过程
- 复合类型
PL/pgSQL
- 概览与编程结构
- 执行查询
- 游标
- 动态命令
- 数组
- 错误处理
- 触发器
- 调试
访问控制
- 访问控制概览
备份
- 逻辑备份
英文课程材料可在 postgrespro.com/community/courses/DEV1 免费获取,用于自学。
DEV2:高级服务器端应用开发
学习时长:4 天
所需背景知识:
了解 PostgreSQL 架构概况。熟练掌握 SQL 和 PL/pgSQL。具备 Unix 操作系统基础知识。
获得的知识与技能:
了解服务器内部机制。在应用逻辑实现中使用 PostgreSQL 的全部能力。扩展数据库功能以解决特定任务。
主题:
架构
- 隔离
- 服务器内部机制
- 清理
- 预写式日志
- 锁
书店
- 书店应用 2.0
可扩展性
- 连接池
- 大值数据类型
- 用户定义数据类型
- 操作符类
- 半结构化数据
- 后台进程
- 异步处理
- 创建扩展
- 编程语言
- 聚合函数与窗口函数
- 全文检索
- 物理复制
- 逻辑复制
- 外部数据
俄文课程材料可在 postgrespro.ru/education/courses/DEV2 免费获取,用于自学。
QPT:查询性能调优
学习时长:2 天
所需背景知识:
熟悉 Unix 操作系统,熟练掌握 SQL。了解一些 PL/pgSQL 会有帮助,但不是必需条件。在 DBA1 课程(面向数据库管理员)或 DEV1 课程(面向开发者)的范围内熟悉 PostgreSQL。
获得的知识与技能:
深入理解查询规划与执行。调优服务器实例的性能。排查查询问题并优化查询。
主题:
航空公司数据库
查询执行
顺序扫描
索引扫描
位图扫描
嵌套循环连接
哈希连接
归并连接
统计信息
查询剖析
优化方法
俄文课程材料可在 postgrespro.ru/education/courses/QPT 免费获取,用于自学。
PGPRO:Postgres Pro Enterprise 特性
学习时长:2 天
所需背景知识:
熟悉 Unix 操作系统,熟练掌握 SQL。了解一些 PL/pgSQL 会有帮助,但不是必需条件。
在 DBA1、DBA2 和 QPT 课程(面向数据库管理员)或 DEV1、DEV2 和 QPT 课程(面向开发者)的范围内熟悉 PostgreSQL。
获得的知识与技能:
熟练掌握 Postgres Pro Enterprise 的特色功能。
主题:
版本与特性
安装、配置、升级
事务管理
CFS——压缩文件系统
查询优化
自适应优化
性能分析
负载报告——pgpro_pwr
用户配置文件
审计
任务规划器
备份——1
备份——2
备份——3
同步集群——多主
俄文课程材料可在 postgrespro.ru/education/courses/PGPRO 获取,用于自学。
专业认证
2019 年启动的认证项目对数据库专业人员及其雇主都有帮助。持有证书可以让你在求职或协商薪资时获得优势,也为客观评估自己的知识提供了良好机会。
对于雇主,认证项目有助于招聘,能够核验现有员工的 PostgreSQL 专业能力,还可以帮助把关员工参加外部培训后的学习成效,或检查第三方供应商和合作伙伴的能力。
目前 PostgreSQL 认证仅面向数据库管理员;未来我们还计划为 PostgreSQL 应用开发者推出认证项目。
我们提供三个认证级别,每个级别都要求通过若干项测试。
Professional 级别确认以下领域的知识:
对 PostgreSQL 架构的总体理解。
服务器安装、使用 psql 以及调优配置设置。
逻辑结构和物理数据结构。
用户与访问管理。
对备份和复制概念的总体理解。
要获得证书,必须成功通过 DBA1 课程测试。对于新申请者,建议选择 PostgreSQL 13 测试版本。
Expert 级别还确认以下领域的知识:
PostgreSQL 内部原理。
服务器设置和监控、数据库维护任务。
性能优化任务、查询调优。
进行备份。
针对各种使用场景设置物理复制和逻辑复制。
有两条认证路径:
获得 PostgreSQL 13 的 Professional 级别认证,并通过 DBA2-13、DBA3-13 和 QPT-13 测试(顺序不限)。
获得 PostgreSQL 10 的 Expert 级别认证,并通过过渡测试 Expert 10–13。
Master 级别还确认 PostgreSQL 数据库管理所需的实践技能。
要获得证书,必须持有 Expert 级别证书并成功通过实践测试。该认证目前仍在开发中。
在 postgrespro.ru/user 创建账户,并在个人资料中报名认证测试。
要通过测试,你应:
熟练掌握相应课程及其所指向的文档章节;
具备通过 psql 使用 PostgreSQL 的实践经验。
测试期间可以查阅我们的课程材料和 PostgreSQL 文档,但禁止使用任何其他信息来源。
达到某个级别后会获得相应证书。证书不会过期,但与特定 PostgreSQL 版本绑定;该版本弃用后,证书也会失去时效。因此,几年后你可能会希望参加更新版本 PostgreSQL 的测试。
有关认证的更多信息,请访问 postgrespro.ru/education/cert。
学术合作
我们公司致力于培养下一代数据库专家。这需要从教育的最早阶段开始努力,而这只有通过与大学、学院和学校合作才能实现。
学术许可证
我们为教育机构提供 Postgres Pro Standard 数据库管理系统的免费学术许可证。申请请发送邮件至 academy@postgrespro.ru。
学生实习
我们在大学设立学生实验室,为学生提供实习机会。我们的专家帮助学生选择与 PostgreSQL 相关的毕业论文,协助他们完成并答辩。
竞赛
我们公司参与组织面向中学生和大学生的黑客松及各种竞赛,包括:
IT-Planet 竞赛中的“Postgres Pro DBMS”赛区:challenge.braim.org/landing/postgres_contest
俄罗斯全国开源项目竞赛:foss.kruzhok.org。
由本公司主办或参与举办的竞赛中获奖或进入决赛的学生,以及合作大学的讲师,可以免费参加专业认证测试。要获得免费认证测试代码,请发送邮件至 certification@postgrespro.ru,并附上证明文件。
学术课程
我们与知名大学的教授合作开发了若干学术课程。所有课程都可以免费用于教育机构。讲师可以使用教材、幻灯片、课程视频及其他发布在我们网站上的教育材料:postgrespro.ru/education/university。
Postgres Professional 参与了莫斯科国立罗蒙诺索夫大学、国立高等经济大学、莫斯科航空学院、列舍特涅夫西伯利亚国立科学技术大学和西伯利亚联邦大学的多门课程。若你是大学代表,希望将数据库课程加入培养方案,欢迎联系我们。
我们也寻求与愿意开发原创 PostgreSQL 课程的教师和讲师合作。我们会提供所需的支持和建议,编辑稿件并推动其出版,还会为课程作者在俄罗斯顶尖大学举办公开讲座做好安排。
SQL 基础
课程学员将学习 PostgreSQL,并能够立即开始使用;无需预先培训。从简单的 SQL 查询开始,学员会逐步学习更复杂的结构,了解事务和查询优化。
本课程以以下(俄文出版的)教材为基础:
E. Morgunov,PostgreSQL:SQL 基础(PostgreSQL. SQL Basics)。圣彼得堡:BHV-Petersburg,2018。
ISBN 978-5-9775-4022-3
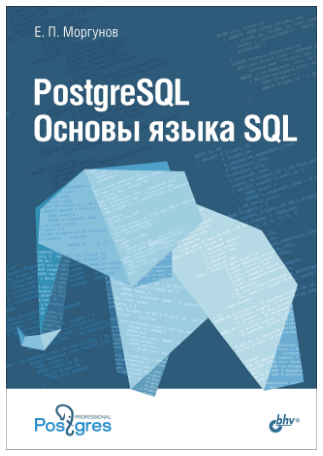
目录:
引言
配置环境
基本操作
数据类型
DDL 基础
查询
数据操作
索引
事务
性能调优
本书的俄文电子版可在我们的网站上获取:postgrespro.ru/education/books/sqlprimer。
本课程包括 36 小时讲座和实践培训。作者多年来一直在莫斯科和克拉斯诺亚尔斯克的顶尖大学讲授这门课程。俄文课程材料可从 postgrespro.ru/education/university/sqlprimer 下载。
Evgeny Morgunov,技术科学博士,列舍特涅夫西伯利亚国立科学技术大学信息学与计算机科学系副教授。
Evgeny 居住在克拉斯诺亚尔斯克。2000 年加入大学之前,他做了十多年程序员,期间参与开发银行应用系统。他于 1998 年开始学习 PostgreSQL。他倡导在学术活动中使用自由开源软件,并发起在“编程技术”课程中使用 PostgreSQL 和 FreeBSD 操作系统。Evgeny 是国际工程教育学会(IGIP)成员。他在教学中使用 PostgreSQL 已超过 20 年。
数据库技术基础
这是一门将数据库设计与部署的深入理论和相关实践技能结合起来的现代学术课程。
B. Novikov、E. Gorshkova 和 N. Grafeeva,数据库技术基础(Database Technology Fundamentals)。第 2 版。莫斯科:DMK Press,2020。
ISBN 978-5-97060-841-8
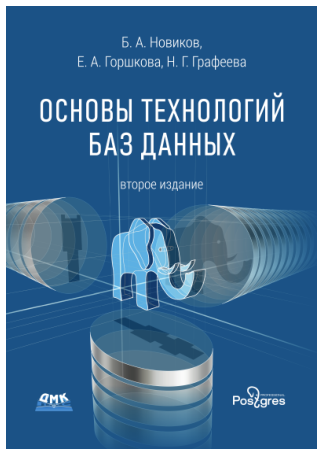
第一部分介绍数据库管理系统的关键信息:关系数据模型、SQL 语言和事务处理。
第二部分深入介绍底层数据库技术及其发展趋势。第一部分涉及的一些主题会在这里以更深的层次再次讨论。
目录:
第一部分:从理论到实践
引言
一些数据库理论
数据库入门
SQL 入门
数据库访问管理
事务与数据一致性
数据库应用开发
关系模型扩展
各种数据库系统类型
第二部分:从实践到熟练掌握
数据库系统架构
存储结构与主要算法
查询执行与优化
事务管理
数据库可靠性
高级 SQL 特性
数据库函数与过程
PostgreSQL 可扩展性
全文检索
数据安全
数据库管理
复制
并行与分布式数据库系统
本书的俄文电子版可在我们的网站上获取:postgrespro.ru/education/books/dbtech。
本课程包括 24 小时讲座和 8 小时实践培训。Boris Novikov 曾在莫斯科国立罗蒙诺索夫大学计算数学与控制论系讲授这门课程。俄文课程材料可从 postgrespro.ru/education/university/dbtech 下载。
Boris Novikov,物理与数学科学博士,圣彼得堡国立高等经济学院信息学系教授。
他的学术兴趣主要涉及数据库系统和应用的设计、开发与部署,以及用于大数据处理和分析的可扩展分布式系统的各个方面。
Ekaterina Gorshkova,物理与数学科学博士。
她是设计高负载数据密集型应用的专家。她的学术兴趣包括机器学习、数据流分析和数据检索。
Natalia Grafeeva,物理与数学科学博士,圣彼得堡国立大学信息学与数据分析系副教授。
她的学术兴趣包括数据库、数据检索、大数据和智能数据分析。她是信息系统设计、开发和维护以及课程设计与教学方面的专家。
书籍
PostgreSQL 内部原理
本书面向那些在使用数据库时不满足于黑盒方法的读者。目标读者是已经具备 PostgreSQL 使用经验的人;对于熟悉其他数据库系统、后来转向 PostgreSQL 并希望理解两者差异的人,本书同样有帮助。
E. Rogov,PostgreSQL 14 内部原理(PostgreSQL 14 Internals)。莫斯科:DMK Press,2022。
ISBN 978-5-6045970-4-0(英文版) ISBN 978-5-93700-305-8(俄文版)
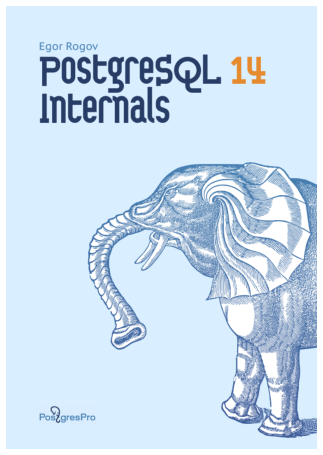
本书不会提供现成的解决方案。但书中对内部机制的解释能帮助读者批判性地评估他人的经验,并得出自己的结论。作者深入介绍 PostgreSQL 内部原理,展示如何运行实验并验证那些不可避免会过时的信息。
Egor Rogov 自 2015 年起在 Postgres Professional 教育部门工作;他开发并讲授培训课程,发表博客文章,撰写和编辑书籍。
目录:
引言
第一部分:隔离与 MVCC
隔离 • 页与元组 • 快照 • 页内剪枝与 HOT 更新 • 清理与自动清理 • 冻结 • 重建表和索引
第二部分:缓冲区缓存与 WAL
缓冲区缓存 • 预写式日志 • WAL 模式
第三部分:锁
关系级锁 • 行级锁 • 杂项锁 • 内存结构上的锁
第四部分:查询执行
查询执行阶段 • 统计信息 • 表访问方法 • 索引访问方法 • 索引扫描 • 嵌套循环 • 哈希 • 排序与归并
第五部分:索引类型
哈希 • B-树 • GiST • SP-GiST • GIN • BRIN
本书的电子版可在我们的网站上获取:postgrespro.com/community/books/internals。
PostgreSQL 监控
监控是 PostgreSQL 管理的关键方面。本书涵盖这一主题,详细介绍可用工具、使用技巧以及处理所获信息的方法。
本书帮助读者了解 PostgreSQL 的运行和监控技术,从而优化数据库性能并有效应对管理方面的挑战。
A. Lesovsky,PostgreSQL 监控(PostgreSQL Monitoring)。莫斯科:Bumba,2024。
ISBN 978-5-907754-42-3
目录:
引言
关于本书
统计信息概览
活动统计
查询和函数执行
数据库
共享内存与输入/输出
预写式日志
复制
清理
操作执行过程
附录:测试环境
Alexey Lesovsky 是一名数据库管理员、系统管理员、开发者和 DevOps 工程师,在管理大型复杂系统以及软件设计与开发方面拥有近 20 年经验。
本书附带 Docker 环境,可用于测试示例和运行实验。对于数据库管理员、系统管理员、可靠性专家和性能优化爱好者来说,这是一本有趣的读物。
本书的俄文电子版可在我们的网站上获取:postgrespro.ru/education/books/monitoring。
数据库指南
本书概述了所有现代数据库管理系统的架构基础,并解释它们使用的算法和数据结构。书中特别关注功能相近的平台如何实现相同的原理。
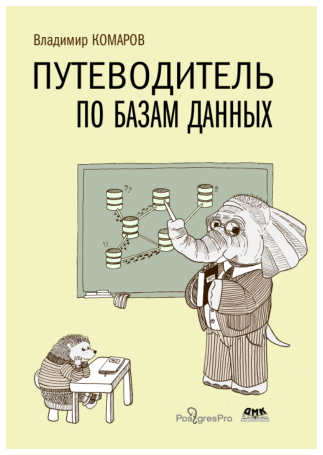
对于那些不满足于“Software Engineering in Three Months”(“三个月学会软件工程”)课程的人,这是一本必读书。它通过帮助读者理解底层模式,补充纯粹的实践技能。本书面向软件架构师和高级开发者——面向精英,也面向希望跻身其中的人。
V. Komarov,数据库指南(A Database Guide)。莫斯科:DMK Press,2024。
ISBN 978-5-93700-287-7
本书的俄文电子版可在我们的网站上获取:postgrespro.ru/education/books/dbguide。
Vladimir Komarov 是一位 IT 通才:软件开发者、数据库管理员、数据与基础设施架构师、讲师,也算半个布道者。
目录:
第一部分:数据库分类
数据模型 • 额外分类标准
第二部分:数据访问
存储结构 • 数据处理
第三部分:数据库管理系统架构
数据一致性保证 • 数据库管理系统结构
第四部分:分布式数据库
分布式妥协 • 修改分布式数据
第五部分:恢复
复制 • 备份
第六部分:数据库运行
数据库管理 • 硬件 • 财务
第七部分:数据库安全
访问控制 • 内部威胁
11 黑客银河漫游指南
新闻与讨论
任何人都可以关注 PostgreSQL 新闻,了解下一版本计划推出的功能,并掌握最新动态。
许多相关博客都发布了有趣而实用的内容。例如,planet.postgresql.org 网站将所有英文文章汇集到一处。在 habr.com/hub/postgresql 可以找到许多俄文文章,其中包括 Postgres Professional 发表的文章。我们的部分文章还提供英文译文,见 habr.com/en/company/postgrespro/blog/。此外,还有专门的 YouTube 频道,例如 youtube.com/RuPostgres 和 youtube.com/PostgresTV。
还有一个 Wiki 项目(wiki.postgresql.org),你可以在那里找到常见问题、培训材料、系统配置与优化文章、从不同数据库系统迁移时需要注意的事项,以及更多内容。
近 14,000 名俄语 PostgreSQL 用户订阅了 Telegram 上的“pgsql—PostgreSQL”频道(t.me/pgsql),形成了一个活跃而乐于助人的社区。
你也可以在 stackoverflow.com 提问。别忘了添加“postgresql”标签。
Postgres Professional 的新闻则发布在公司博客上:postgrespro.com/blog。
邮件列表
如果希望第一时间获知所有新闻,不必等别人写成博客文章,你可以订阅邮件列表。按照传统,PostgreSQL 开发者完全通过电子邮件讨论所有问题。
你可以在 postgresql.org/list 找到所有邮件列表。其中包括:
pgsql-hackers(通常简称“hackers”):讨论所有开发相关事项的主要列表
pgsql-general:讨论一般性问题
pgsql-bugs:报告缺陷
pgsql-docs:讨论文档
pgsql-translators:讨论翻译相关事项
pgsql-announce:接收新版本发布公告
还有许多其他列表。
订阅后,你就会定期收到邮件,也可以按自己的意愿参与讨论。另一种方式是在 postgresql.org/list 或我们公司的网站(postgrespro.com/list)上浏览邮件归档。
Commitfest
如果希望关注动态又不花太多时间,还有一种方式是查看 commitfest.postgresql.org 页面。社区会在这里开设称为 Commitfest 的补丁集中审阅活动,供开发者提交补丁。例如,2024 年 3 月 1 日至 3 月 31 日的 Commitfest 面向版本 17,而 2024 年 7 月 1 日至 7 月 31 日的 Commitfest 已经面向下一版本。这样,社区就能在版本发布前至少约六个月停止接收新功能,留出时间稳定代码。
补丁要经历几个阶段:先接受审阅和修改,然后被采纳、移至下一次 Commitfest,或者(如果运气实在不好)被拒绝。
通过这种方式,你可以了解 PostgreSQL 已经纳入的新功能,以及计划在下一版本推出的功能。
会议
莫斯科、圣彼得堡及俄罗斯其他城市会举办一年一度的国际会议 PGConf(pgconf.ru),有数百名 PostgreSQL 用户和开发者参加。
此外,俄罗斯的一些城市还会举办主题更广泛的会议,既涉及数据库的一般话题,也专门讨论 PostgreSQL。这里只列举其中几个:
莫斯科及其他城市的 HighLoad++(highload.ru);
新西伯利亚的 CodeFest(codefest.ru);
圣彼得堡(dump-spb.ru)和叶卡捷琳堡(dump-ekb.ru)的 DUMP;
乌里扬诺夫斯克的 Stachka(nastachku.ru);
莫斯科的 Heisenbug(heisenbug.ru);
莫斯科的 Sysconf(sysconf.pro)。
当然,世界各地都会举办 PostgreSQL 会议。主要会议包括:
加拿大渥太华的 PGCon(pgcon.org)
PGConf Europe(pgconf.eu)
即将举办的活动列表可见 postgresql.org/about/events。
除了会议,还有一些定期举办、较为随意的聚会,其中也包括线上聚会。
12 Postgres Professional
Postgres Professional 公司成立于 2015 年,汇聚了俄罗斯的主要 PostgreSQL 开发者,他们的贡献得到了全球社区的认可。公司致力于在俄罗斯培养数据库开发能力,目前拥有约 400 名开发者、架构师、工程师及其他专业人员。
Postgres Professional 公司提供基于 PostgreSQL 的多个 Postgres Pro 数据库系统版本,开发新的核心功能和扩展,并为应用系统设计、维护及向 PostgreSQL 迁移提供支持。
公司非常重视教育,在莫斯科主办规模最大的年度 PostgreSQL 国际会议 PgConf.Russia,也参加世界各地的其他会议。
联系信息:
7A Dmitry Ulyanov str., Moscow, Russia, 117036
+7 495 150-06-91
Postgres Pro 数据库系统
Postgres Pro 是 Postgres Professional 公司开发的俄罗斯商业数据库系统。它基于开源的 PostgreSQL 数据库系统,提供许多额外功能以满足企业客户的需求,并已列入俄罗斯软件统一名录。
Postgres Pro Standard 包含 PostgreSQL 的全部功能,还提供额外的扩展和核心补丁,其中也包括尚未被社区采纳的内容。因此,用户不必等到 PostgreSQL 下一版本发布,就能使用实用的新功能并提升性能。
Postgres Pro Enterprise 是经过大幅改进的数据库系统版本,提供更好的稳定性和更高的性能,能够应对生产环境中的复杂任务。
Postgres Pro 的这两个版本都增加了所需的信息安全功能,并已通过 FSTEC(俄罗斯联邦技术与出口管制局)认证。
使用任一 Postgres Pro 版本都需要购买许可证。试用版可以免费获取;用于教育或应用开发时,也可以免费获得 Postgres Pro。
教育机构可以获得免费的 Postgres Pro Standard 学术许可证。
有关 Postgres Pro 不同版本的特色功能,请访问 postgrespro.com/products。
Postgres Pro Enterprise Manager
Postgres Pro Enterprise Manager(PPEM)是 Postgres Pro Enterprise 的集成控制面板。
PPEM 是一个一体化控制台,提供简洁的监控与管理界面。你可以在网页浏览器中执行常见管理任务,并通过统一入口访问所有数据库和实例。PPEM 能提高数据库管理团队的效率,加快日常管理工作。
详情请见:postgrespro.ru/products/PPEM。
Postgres Pro Backup Enterprise
Postgres Pro Backup Enterprise(pg_probackup)是 PostgreSQL 数据库集簇的备份与恢复工具。
它使用的集中式备份目录可存储在本地或远程(包括 S3 存储)。
Pro Backup 支持页级增量备份、备份存储策略、完整性验证、时间点恢复、并行备份与恢复、数据压缩和 CFS 文件系统。
详情请见:postgrespro.ru/products/pg_probackup。
Shardman
Shardman 是基于 PostgreSQL 的分布式关系数据库管理系统,具有 Postgres Pro 的全部扩展功能。
Shardman 兼容 PostgreSQL,为数据隔离和一致性提供有力保证,支持水平伸缩,并内置冗余机制。
详情请见:postgrespro.ru/products/shardman。
加入我们
我们一直在寻找愿意帮助发展 Postgres 生态乃至整个开源社区的人。
Postgres Professional 团队汇聚了大多数俄罗斯 PostgreSQL 贡献者。我们为 PostgreSQL 及其扩展开发内核层代码,打造用于数据库监控和管理的生态产品。我们的专家开发 DBaaS 解决方案,开展技术审计和迁移,提供技术支持,参与研究并推动创新。
我们正在招聘系统软件工程师、后端和前端开发者、DevOps 工程师、QA 工程师、数据库管理员及其他专业人员。详情请查看我们的招聘网站:career.postgrespro.ru。
服务
Postgres 容错解决方案
设计和实施高负载、高性能、具备容错能力的生产系统,提供咨询服务。部署 Postgres 并优化系统配置。
原厂技术支持
为 Postgres Pro 和 PostgreSQL 提供 24x7 支持:系统监控、灾难恢复、事件分析、性能管理,以及核心功能和扩展的调试。
应用系统迁移
评估从其他数据库系统迁移到 Postgres 的复杂度。确定新解决方案的架构及所需变更。将应用系统迁移到 Postgres,并在迁移过程中提供支持。
Postgres 培训
面向数据库管理员、系统架构师和应用开发者的课程,介绍 Postgres 的特点,以及如何高效利用其优势。
数据库系统审计
由 Postgres Professional 专家评估数据库系统,并对基于 Postgres 的系统开展信息安全审计。
完整的服务列表见 postgrespro.com/services。
出版信息与致谢
Pavel Luzanov · Egor Rogov · Igor Levshin
PostgreSQL 入门(Postgres. The First Experience)
英文版译者:Liudmila Mantrova 与 Alexander Meleshko 封面设计:Eteri Bezhashvili
第 11 版,修订更新版
postgrespro.com/community/books/introbook
© Postgres Professional, 2016–2025
ISBN 978-5-6045970-8-8
中文版本说明:中文版本署名冯若航,使用 Codex 辅助翻译与校对。以上原作作者、英文版译者、封面设计与出版信息均按原版保留。