# 体验 SQL
> 使用 psql 连接 PostgreSQL,创建表、查询和修改数据、组合关系,并尝试事务。
---
LLMS 索引: [llms.txt](/llms.txt)
---
## 通过 psql 连接 {#intro-section-4-1}
要连接数据库服务器并开始执行命令,需要一个客户端应用程序。在“应用中的 PostgreSQL”一章中,我们将讨论如何从使用不同编程语言编写的应用程序中发送查询。这里我们将介绍如何在命令行的交互模式下使用 `psql` 客户端。
如今,许多人并不喜欢命令行。不过,掌握它确实很有价值。
首先,`psql` 是所有 PostgreSQL 软件包都包含的标准客户端应用程序,因此总是可以使用。拥有定制的环境当然有好处,但到了陌生系统上,也不必因此无所适从。
其次,`psql` 很适合执行日常 DBA 任务、编写小型查询以及自动化流程。例如,可以使用它定期在数据库服务器上部署应用程序代码更新。`psql` 客户端还提供了自己的命令,帮助你了解数据库对象,并以方便的格式显示表中存储的数据。
不过,如果你习惯使用图形用户界面,可以尝试 pgAdmin(稍后还会再次介绍)或其他类似产品:[wiki.postgresql.org/wiki/Community\_Guide\_to\_PostgreSQL\_GUI\_Tools.]()
要在 Linux 系统上启动 `psql`,请运行以下命令:
```bash
$ sudo -u postgres psql
```
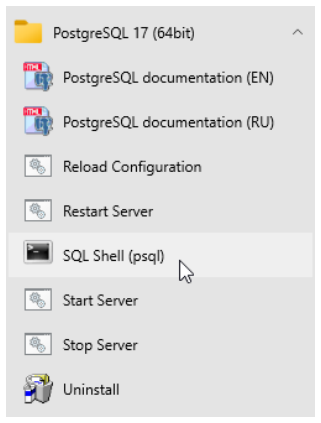
{#intro-fig-4-1 num="4.1" caption="从开始菜单启动 SQL Shell" .book-original-figure width=214 height=281}
在 Windows 上,打开“开始”菜单并启动“SQL Shell (psql)”程序。出现提示后,输入安装 PostgreSQL 时为 `postgres` 用户设置的密码。
Windows 用户在终端查看非拉丁字母字符时可能遇到编码问题。如果出现这种情况,请确保在终端窗口的属性中选择了 TrueType 字体(通常是“Lucida Console”或“Consolas”)。
这样,在两种操作系统上都应该看到相同的提示符:`postgres=#`。这里的“postgres”是当前连接的数据库名称。单个 PostgreSQL 服务器可以提供多个数据库,但你一次只能使用其中一个。
现在来尝试几个命令。只输入粗体显示的部分;提示符和系统响应仅为方便起见列出。
## 数据库 {#intro-section-4-2}
创建一个名为 `test` 的新数据库:
```psql
postgres=# CREATE DATABASE test;
CREATE DATABASE
```
别忘了用分号结束每条命令:PostgreSQL 会一直等待你继续输入,直到输入这个符号(因此可以把命令拆成多行)。
现在连接到刚创建的数据库:
```psql
postgres=# \c test
You are now connected to database "test" as user
"postgres".
test=#
```
如你所见,命令提示符已变为 `test=#`。
刚才输入的命令看起来不像 SQL,因为它以反斜杠开头。这是只能在 `psql` 中运行的特殊命令约定。如果使用 pgAdmin 或其他 GUI 工具,请跳过所有以反斜杠开头的命令,或者寻找等效命令。
`psql` 命令有不少,我们稍后会用到其中一些。现在可以运行以下命令,查看 `psql` 命令的完整列表:
```psql
test=# \?
```
参考信息较多,通常会由操作系统的分页器程序显示,一般是 `more` 或 `less`。
## 表 {#intro-section-4-3}
关系数据库管理系统以**表**的形式呈现数据。表的结构由**列**定义,数据本身存储在表的**行**中。数据没有顺序,因此各行不一定按照加入表中的顺序存储。
每一列都有一个**数据类型**。各行中与这一列对应的字段值都必须属于该类型。你可以使用 PostgreSQL 提供的多种内置数据类型([postgrespro.com/doc/datatype]()),也可以添加自定义类型,但这里我们只介绍几种主要类型:
- `integer`
- `text`
- `boolean`,这是一种取 `true` 或 `false` 值的逻辑数据类型
除了数据类型定义的常规值外,字段还可以是 `NULL`。它可以解释为“值未知”或“值未设置”。
创建一个大学课程表:
```psql
test=# CREATE TABLE courses(
test(# c_no text PRIMARY KEY,
test(# title text,
test(# hours integer
test(# );
CREATE TABLE
```
注意,`psql` 命令提示符发生了变化:这表示命令会在新行继续输入。为方便起见,下面的示例中不再重复每一行的提示符。
上述命令创建了包含三列的 `courses` 表:`c_no` 指定以文本字符串表示的课程编号,`title` 提供课程名称,`hours` 以整数表示授课课时数。
除了列和数据类型,还可以定义会自动检查的完整性约束:PostgreSQL 不会允许无效数据进入数据库。本例添加了 `PRIMARY KEY` 约束,并将其应用于 `c_no` 列。这意味着该列中的所有值都必须唯一,并且不允许使用 `NULL`。这样的列可用于区分表中的不同行。所有可用的约束见 [postgrespro.com/doc/ddl-constraints]()。
你可以在文档中查找 `CREATE TABLE` 命令的完整语法,也可以直接在 `psql` 中查看命令行帮助:
```psql
test=# \help CREATE TABLE
```
每个 SQL 命令都有这样的参考信息。要获取 SQL 命令的完整列表,请不带参数运行 `\help`。
## 填充表中的数据 {#intro-section-4-4}
将一些行插入刚创建的表:
```psql
test=# INSERT INTO courses(c_no, title, hours)
VALUES ('CS301', 'Databases', 30),
('CS305', 'Networks', 60);
```
```sql
INSERT 0 2
```
如果需要从外部来源批量加载数据,`INSERT` 命令不是最佳选择。相反,可以使用专门为此设计的 `COPY` 命令:[postgrespro.com/doc/sql-copy.]()
后续示例还需要另外两个表:`students` 和 `exams`。
对于每名学生,我们将存储其姓名和入学年份(起始年份)。学生 ID 编号将作为学生的标识符。
```psql
test=# CREATE TABLE students(
s_id integer PRIMARY KEY,
name text,
start_year integer
);
```
```sql
CREATE TABLE
```
```psql
test=# INSERT INTO students(s_id, name, start_year)
VALUES (1451, 'Anna', 2014),
(1432, 'Victor', 2014),
(1556, 'Nina', 2015);
```
```sql
INSERT 0 3
```
`exams` 表包含学生在相应课程中取得的所有成绩。因此,学生和课程通过多对多关系连接:每名学生可以参加多门课程的考试,每场考试也可以由多名学生参加。
表中的每一行都由学生 ID 和课程编号的组合唯一标识。适用于多个列的这种完整性约束由 `CONSTRAINT` 子句定义:
```psql
test=# CREATE TABLE exams(
s_id integer REFERENCES students(s_id),
c_no text REFERENCES courses(c_no),
score integer,
CONSTRAINT pk PRIMARY KEY(s_id, c_no)
);
CREATE TABLE
```
此外,这里的 `REFERENCES` 子句定义了两个引用完整性检查,称为**外键**。这样的键表示一个表中的值**引用**另一个表中的行。
每次对数据库执行操作后,PostgreSQL 都会检查 `exams` 表中的所有 `s_id` 标识符是否对应真实学生(即 `students` 表中的条目),同时检查 `c_no` 课程编号是否对应真实课程。因此,无论用户执行什么操作或应用程序出现什么错误,都不可能给不存在的课程或不存在的学生赋分。
为学生录入几项成绩:
```psql
test=# INSERT INTO exams(s_id, c_no, score)
VALUES (1451, 'CS301', 5),
(1556, 'CS301', 5),
(1451, 'CS305', 5),
(1432, 'CS305', 4);
INSERT 0 4
```
## 数据检索 {#intro-section-4-5}
### 简单查询 {#intro-subsection-4-5-1}
要从表中读取数据,请使用 SQL 语句 `SELECT`。例如,我们来显示 `courses` 表中的两列。必要时,`AS` 子句可以重命名列:
```psql
test=# SELECT title AS course_title, hours
FROM courses;
course_title | hours
--------------+-------
Databases | 30
Networks | 60
(2 rows)
```
星号 `*` 会显示所有列:
```psql
test=# SELECT * FROM courses;
c_no | title | hours
-------+-------------+-------
CS301 | Databases | 30
CS305 | Networks | 60
(2 rows)
```
在生产应用程序中,建议只显式指定真正需要的列:这样查询执行得更高效,结果也不会受以后新增列的影响。但在交互式查询中,直接使用星号即可。
结果可能包含多行相同的数据。即使原表中的所有行都不相同,如果没有显示所有列,数据也可能看起来重复:
```psql
test=# SELECT start_year FROM students;
start_year
------------
2014
2014
2015
(3 rows)
```
要选择所有**不同的**入学年份,请在 `SELECT` 后指定 `DISTINCT` 关键字:
```psql
test=# SELECT DISTINCT start_year FROM students;
start_year
------------
2014
2015
(2 rows)
```
详情见文档:[postgrespro.com/doc/sql-select#SQL-DISTINCT.]()
一般来说,可以在 `SELECT` 语句后使用任意表达式。如果省略 `FROM` 子句,查询将返回一行。例如:
```psql
test=# SELECT 2+2 AS result;
result
--------
4
(1 row)
```
从表中选择数据时,通常需要只返回满足某个条件的行。这个过滤条件在 `WHERE` 子句中指定:
```psql
test=# SELECT * FROM courses WHERE hours > 45;
c_no | title | hours
-------+----------+-------
CS305 | Networks | 60
(1 row)
```
条件必须是逻辑类型。例如,它可以包含操作符 `=`、`<>`(或 `!=`)、`>`、`>=`、`<`、`<=`,也可以像普通编程语言一样使用逻辑运算 `AND`、`OR`、`NOT` 和括号组合简单条件。
处理 `NULL` 稍微复杂一些。结果只包含过滤条件为真的行;如果条件为假或**未定义**,该行就会被排除。
请记住:
- 将某个值与 `NULL` 比较的结果是未定义的。
- 对 `NULL` 执行逻辑运算的结果通常是未定义的(例外:`true OR NULL = true`、`false AND NULL = false`)。
- 要检查值是否未定义,可使用以下操作符:`IS NULL`(`IS NOT NULL`)和 `IS DISTINCT FROM`(`IS NOT DISTINCT FROM`)。
`coalesce` 表达式常用于将 `NULL` 值替换为其他内容,例如文本类型替换为空字符串,数值类型替换为零。
更多详情见文档:[postgrespro.com/doc/functions-comparison.]()
## 连接 {#intro-section-4-6}
设计良好的数据库不应包含冗余数据。例如,`exams` 表不应包含学生姓名,因为可以通过学生证号在另一张表中找到这些信息。
因此,为了在查询中获取所有所需的值,通常需要连接多个表,并在 `FROM` 子句中指定它们的名称:
```psql
test=# SELECT * FROM courses, exams;
```
```text
c_no | title | hours | s_id | c_no | score
-------+-------------+-------+------+-------+-------
CS301 | Databases | 30 | 1451 | CS301 | 5
CS305 | Networks | 60 | 1451 | CS301 | 5
CS301 | Databases | 30 | 1556 | CS301 | 5
```
```text
CS305 | Networks | 60 | 1556 | CS301 | 5
CS301 | Databases | 30 | 1451 | CS305 | 5
CS305 | Networks | 60 | 1451 | CS305 | 5
CS301 | Databases | 30 | 1432 | CS305 | 4
CS305 | Networks | 60 | 1432 | CS305 | 4
(8 rows)
```
此结果称为表的直积或笛卡尔积:一个表的每一行都会与另一个表的每一行拼接。
通常,如果在 `WHERE` 子句中指定连接条件,就能得到更有用、信息更丰富的结果。让我们将课程与相应的考试匹配起来,获取所有课程的全部成绩:
```psql
test=# SELECT courses.title, exams.s_id, exams.score
FROM courses, exams
WHERE courses.c_no = exams.c_no;
```
```text
title | s_id | score
-------------+------+-------
Databases | 1451 | 5
Databases | 1556 | 5
Networks | 1451 | 5
Networks | 1432 | 4
(4 rows)
```
连接表的另一种方式是显式使用 `JOIN` 关键字。让我们显示所有学生及其“Networks”课程成绩:
```psql
test=# SELECT students.name, exams.score
FROM students
JOIN exams
ON students.s_id = exams.s_id
AND exams.c_no = 'CS305';
```
```text
name | score
--------+-------
Anna | 5
Victor | 4
(2 rows)
```
从数据库角度看,这些查询完全等价,因此可以使用你觉得更自然的任何方法。
在本例中,如果连接子句左侧指定的表中的行在右侧表中没有匹配项,结果不会包含这些行:尽管条件应用于课程,但没有参加这门课程考试的学生也会被排除。要将所有学生都包含在结果中,我们必须使用外连接:
```psql
test=# SELECT students.name, exams.score
FROM students
LEFT JOIN exams
ON students.s_id = exams.s_id
AND exams.c_no = 'CS305';
name | score
--------+-------
Anna | 5
Victor | 4
Nina |
(3 rows)
```
注意,左表中没有右表对应项的行会被添加到结果中(因此该操作称为 `LEFT JOIN`)。此时右表的相应值为 NULL。
`WHERE` 条件会应用于连接操作的结果。因此,如果将课程限制从连接条件移到 `WHERE` 子句中,Nina 就会因相应的 `exams.c_no` 为 `NULL` 而从结果中排除:
```psql
test=# SELECT students.name, exams.score
FROM students
LEFT JOIN exams ON students.s_id = exams.s_id
WHERE exams.c_no = 'CS305';
```
```text
name | score
--------+-------
Anna | 5
Victor | 4
(2 rows)
```
不要害怕连接。对于数据库管理系统来说,这是常见操作,而 PostgreSQL 提供了整套高效机制来执行连接。不要在应用程序层连接数据;让数据库服务器妥善处理。
更多详情见文档:[postgrespro.com/doc/sql-select#SQL-FROM.]()
## 子查询 {#intro-section-4-7}
`SELECT` 操作返回一张表,它既可以像我们已经看到的那样作为查询结果显示,也可以用于另一个 SQL 查询。用括号括起来的这种嵌套 `SELECT` 命令称为**子查询**。
如果子查询恰好返回一行一列,就可以把它作为普通的标量表达式使用:
```psql
test=# SELECT name,
(SELECT score
FROM exams
WHERE exams.s_id = students.s_id
AND exams.c_no = 'CS305')
FROM students;
```
```text
name | score
--------+-------
Anna | 5
Victor | 4
Nina |
(3 rows)
```
如果用于 `SELECT` 表达式列表中的标量子查询不包含任何行,则返回 `NULL`(如上例结果的最后一行)。因此,可以用连接替换标量子查询来展开它们,但必须使用外连接。
标量子查询也可用于过滤条件。让我们显示 2014 年后入学的学生参加的所有考试:
```psql
test=# SELECT *
FROM exams
WHERE (SELECT start_year FROM students
WHERE students.s_id = exams.s_id) > 2014;
s_id | c_no | score
------+-------+-------
1556 | CS301 | 5
(1 row)
```
还可以为返回任意数量行的子查询添加过滤条件。SQL 为此提供了几个谓词。例如,`IN` 会检查子查询返回的表是否包含指定值。
让我们显示在指定课程中取得过任何成绩的所有学生:
```psql
test=# SELECT name, start_year
FROM students
WHERE s_id IN (SELECT s_id FROM exams
WHERE c_no = 'CS305');
```
```text
name | start_year
--------+------------
Anna | 2014
Victor | 2014
(2 rows)
```
`NOT IN` 形式的谓词也会返回相反结果。例如,以下查询会返回没有取得过任何优秀成绩的学生列表:
```psql
test=# SELECT name, start_year
FROM students
WHERE s_id NOT IN (SELECT s_id
FROM exams
WHERE score = 5);
```
```text
name | start_year
--------+------------
Victor | 2014
(1 rows)
```
注意,查询结果也可能包含完全没有取得任何成绩的学生。
另一个选项是使用 `EXISTS` 谓词,它会检查子查询是否至少返回一行。使用该谓词,可以将前一个查询改写如下:
```psql
test=# SELECT name, start_year
FROM students
WHERE NOT EXISTS (SELECT s_id
FROM exams
WHERE exams.s_id = students.s_id
AND score = 5);
```
```text
name | start_year
--------+------------
Victor | 2014
(1 rows)
```
更多详情见文档:[postgrespro.com/doc/functions-subquery.]()
在上面的示例中,我们为列名加上表名以避免歧义,但这并不总是足够。例如,同一张表可能在查询中使用两次,或者 `FROM` 子句中可能包含一个没有名称的子查询,而不是表名。在这种情况下,可以在查询后指定一个任意名称,这称为别名。普通表也可以指定别名。
让我们显示“Databases”课程的学生姓名和成绩:
```psql
test=# SELECT s.name, ce.score
FROM students s
JOIN (SELECT exams.*
FROM courses, exams
WHERE courses.c_no = exams.c_no
AND courses.title = 'Databases') ce
ON s.s_id = ce.s_id;
```
```text
name | score
------+-------
Anna | 5
Nina | 5
(2 rows)
```
这里,“`s`”是表别名,而“`ce`”是子查询别名。应该选择简短而又能完整表达含义的别名。
同一个查询也可以不使用子查询来编写:
```psql
test=# SELECT s.name, e.score
FROM students s, courses c, exams e
WHERE c.c_no = e.c_no
AND c.title = 'Databases'
AND s.s_id = e.s_id;
```
## 排序 {#intro-section-4-8}
如我们所知,表中的数据没有排序。要按特定顺序返回行,可以使用带有排序表达式列表的 `ORDER BY` 子句。在每个表达式(排序键)之后,可以指定排序方向:`ASC` 表示升序(默认使用),`DESC` 表示降序。
```psql
test=# SELECT * FROM exams
ORDER BY score, s_id, c_no DESC;
s_id | c_no | score
------+-------+-------
1432 | CS305 | 4
1451 | CS305 | 5
1451 | CS301 | 5
1556 | CS301 | 5
(4 rows)
```
这里首先按成绩升序排列各行。成绩相同时,再按学生证号升序排列。如果前两个键相同,则再按课程编号降序排列。
合理的做法是在查询结束、即将返回结果之前对数据排序;子查询中通常不需要进行这项操作。
更多详情见文档:[postgrespro.com/doc/sql-select#SQL-ORDERBY.]()
## 分组 {#intro-section-4-9}
使用分组时,查询会返回根据原表中存储的多行数据计算出的汇总数据。
分组通常会涉及**聚合函数**。例如,可以这样显示参加考试的总次数、通过考试的学生人数以及平均成绩:
```psql
test=# SELECT count(*), count(DISTINCT s_id),
avg(score)
FROM exams;
count | count | avg
-------+-------+--------------------
4 | 3 | 4.7500000000000000
(1 row)
```
如果提供包含分组键的 `GROUP BY` 子句,就可以按课程编号获取类似信息:
```psql
test=# SELECT c_no, count(*),
count(DISTINCT s_id), avg(score)
FROM exams
GROUP BY c_no;
c_no | count | count | avg
-------+-------+-------+--------------------
CS301 | 2 | 2 | 5.0000000000000000
CS305 | 2 | 2 | 4.5000000000000000
(2 rows)
```
聚合函数的完整列表见 [postgrespro.com/doc/functions-aggregate.]()
在使用分组的查询中,可能需要根据聚合结果过滤行。可以在 `HAVING` 子句中定义此类条件。`WHERE` 条件在分组前应用(可以使用原表的列),而 `HAVING` 条件在分组后生效(因此也可以使用结果表的列)。
让我们选出在任意课程中取得超过一次优秀成绩(5 分)的学生姓名:
```psql
test=# SELECT students.name
FROM students, exams
WHERE students.s_id = exams.s_id AND exams.score = 5
GROUP BY students.name
HAVING count(*) > 1;
name
------
Anna
(1 row)
```
更多详情见文档:[postgrespro.ru/doc/sql-select#SQL-GROUPBY.]() (链接已修正为 PostgreSQL 17 参考文档;印刷版目标地址不可用。)
## 修改和删除数据 {#intro-section-4-10}
要修改表中的数据,应使用 `UPDATE` 语句;它会为 `WHERE` 子句指定的行提供新的字段值(与 `SELECT` 语句类似)。
例如,将“Databases”课程的授课课时数加倍:
```psql
test=# UPDATE courses
SET hours = hours * 2
WHERE c_no = 'CS301';
UPDATE 1
```
更多详情见文档:[postgrespro.com/doc/sql-update.]()
同样,`DELETE` 语句会删除 `WHERE` 子句指定的行:
```psql
test=# DELETE FROM exams WHERE score < 5;
DELETE 1
```
## 事务 {#intro-section-4-11}
让我们稍微扩展一下数据库模式,并将学生分配到各个小组。每个小组必须有一名组长(同组学生,负责本组学生的活动)。为此,创建 `groups` 表:
```psql
test=# CREATE TABLE groups(
g_no text PRIMARY KEY,
monitor integer NOT NULL REFERENCES students(s_id)
);
CREATE TABLE
```
这里应用了 `NOT NULL` 约束,它禁止使用未定义的值。
现在需要在 `students` 表中添加一列:组编号。幸运的是,可以向已经存在的表中添加新列:
```psql
test=# ALTER TABLE students
ADD g_no text REFERENCES groups(g_no);
ALTER TABLE
```
使用 `psql` 命令,你随时可以检查表中定义了哪些列:
```psql
test=# \d students
Table "public.students"
Column | Type | Modifiers
------------+---------+----------
s_id | integer | not null
name | text |
start_year | integer |
g_no | text |
...
```
还可以获取数据库中所有可用表的列表:
```psql
test=# \d
```
```text
List of relations
Schema | Name | Type | Owner
--------+----------+-------+----------
public | courses | table | postgres
public | exams | table | postgres
public | groups | table | postgres
public | students | table | postgres
(4 rows)
```
现在创建一个名为“A-101”的新小组,将所有学生移入该小组,并让 Anna 担任组长。
注意以下细节:没有组长就无法创建小组,但学生只有已经属于该小组才能担任组长,否则数据在逻辑上就不正确且不一致。单独执行这两个操作都没有意义,必须同时完成。**事务**是一组构成不可分割逻辑工作单元的操作。
那么,开始事务:
```psql
test=# BEGIN;
```
```sql
BEGIN
```
接下来,需要创建一个新小组,同时指定其组长。当然,我们不可能记住所有学生的 ID,因此将把下面的查询直接放入添加新行的命令中:
```sql
test=*# INSERT INTO groups(g_no, monitor)
SELECT 'A-101', s_id
FROM students
WHERE name = 'Anna';
INSERT 0 1
```
提示符中的星号提醒我们,事务尚未完成。
现在打开一个新的终端窗口,再启动另一个 `psql` 进程:这个会话将与第一个会话并行运行。为避免混淆,我们会缩进第二个会话的命令。
第二个会话能看到第一个会话所做的更改吗?
```psql
postgres=# \c test
```
```text
You are now connected to database "test" as user
"postgres".
```
```psql
test=# SELECT * FROM groups;
```
```text
g_no | monitor
------+---------
(0 rows)
```
不能,因为事务尚未完成。
继续事务,将所有学生移入新建的小组:
```sql
test=*# UPDATE students SET g_no = 'A-101';
UPDATE 3
```
第二个会话仍然看到一致的数据;这些数据在未提交事务开始时已经存在于数据库中。
```psql
test=# SELECT * FROM students;
```
```text
s_id | name | start_year | g_no
------+--------+------------+------
1451 | Anna | 2014 |
1432 | Victor | 2014 |
1556 | Nina | 2015 |
(3 rows)
```
提交所有更改,完成事务:
```sql
test=*# COMMIT;
```
```sql
COMMIT
```
最后,第二个会话收到该事务所做的全部更改,就好像它们同时出现一样:
```psql
test=# SELECT * FROM groups;
```
```text
g_no | monitor
-------+---------
A-101 | 1451
(1 row)
```
```psql
test=# SELECT * FROM students;
```
```text
s_id | name | start_year | g_no
------+--------+------------+-------
1451 | Anna | 2014 | A-101
1432 | Victor | 2014 | A-101
1556 | Nina | 2015 | A-101
(3 rows)
```
可以保证数据库系统始终满足若干重要特性。
首先,任何事务要么完整执行(如上例),要么完全不执行。如果至少有一条命令产生错误,或者我们使用 `ROLLBACK` 命令中止事务,数据库就会保持在 `BEGIN` 命令之前的状态。这一特性称为**原子性**。
其次,提交事务时,所有完整性约束都必须成立,否则事务必须中止。事务开始时数据是一致的,事务结束时仍然一致,这正是该特性得名的原因:**一致性**。
第三,如示例所示,其他用户永远不会看到事务尚未提交的不一致数据。这一特性称为**隔离性**。借助这一特性,数据库系统可以同时服务多个会话,而不牺牲数据一致性。
PostgreSQL 以高效的隔离机制实现而闻名:多个会话可以并行执行读写操作,彼此不会阻塞。只有两个不同进程同时尝试修改同一行时才会发生阻塞。
最后,**持久性**得到保证:即使发生故障,已提交的数据也永远不会丢失(当然,前提是数据库配置正确并且定期备份)。
这些特性极其重要;很难想象没有它们的关系数据库管理系统。
要了解更多事务信息,请参阅 [postgrespro.com/doc/tutorial-transactions]()(更多细节见 [postgrespro.com/doc/mvcc]())。
## 实用 psql 命令 {#intro-section-4-12}
**\\?** `psql` 的命令行参考。
**\\h** SQL 参考:可用命令列表或特定命令的语法。
**\\x** 在常规表显示(行和列)与扩展显示(每列单独一行)之间切换。查看多行宽度较大的数据时很有用。
**\\l** 数据库列表。
**\\du** 用户列表。
**\\dt** 表列表。
**\\di** 索引列表。
**\\dv** 视图列表。
**\\df** 函数列表。
**\\dn** 模式列表。
**\\dx** 已安装扩展列表。
**\\dp** 权限列表。
**\\d name** 指定对象的详细信息。
**\\d+ name** 指定对象的扩展详细信息。
**\\timing on** 显示语句执行时间。
## 结语 {#intro-section-4-13}
我们只介绍了 PostgreSQL 所需知识的一小部分,但希望你已经发现入门并不困难。SQL 语言可以构造各种复杂程度的查询,而 PostgreSQL 则提供了高效的实现和对标准的高质量支持。请亲自尝试和实验!
还有一个重要的 `psql` 命令。要结束会话,请输入:
```psql
test=# \q
```